
خمسة مطاعم قريبة من بيتك. واحد منهم غالباً هو الأفضل.
لو الجودة الحقيقية مكتوبة على الباب، المسألة مملّة:
قارن متوسط الجودة بكل مطعم، واختار الأعلى.
بس الأرقام مش مكتوبة. لازم تكتشفها بالأكل. عشا واحد بيعطيك إشارة، مش الحقيقة كلها. يمكن الشيف كان تعبان. يمكن إنت طلبت الطبق الغلط. يمكن المطعم ممتاز وإنت وقعت على أسوأ طبق عنده.
هون بتظهر حدود فكرة الترتيب البسيطة.
بنحكي عن ترتيب مطاعم أو منتجات أو نماذج أو إعلانات أو لاعبين أو صانعي محتوى. لكن بالأنظمة الفعلية، القيمة اللي بدنا نعتمد عليها بالترتيب غالباً مجهولة. ما بنقرأها من جدول جاهز؛ بنصرف وقتاً أو مالاً أو فرص عرض حتى نتعلّم عنها.
كل محاولة إلها وجهين: بتعطيك نتيجة الآن، وبتغيّر اللي بتعرفه بعدين.
قبل اختيار الخوارزمية، لازم نميّز بين شغلتين:
- شكل القرار — شو مسموح تختار.
- نوع التغذية الراجعة — شو المعلومة اللي بتوصلك بعد تنفيذ القرار.
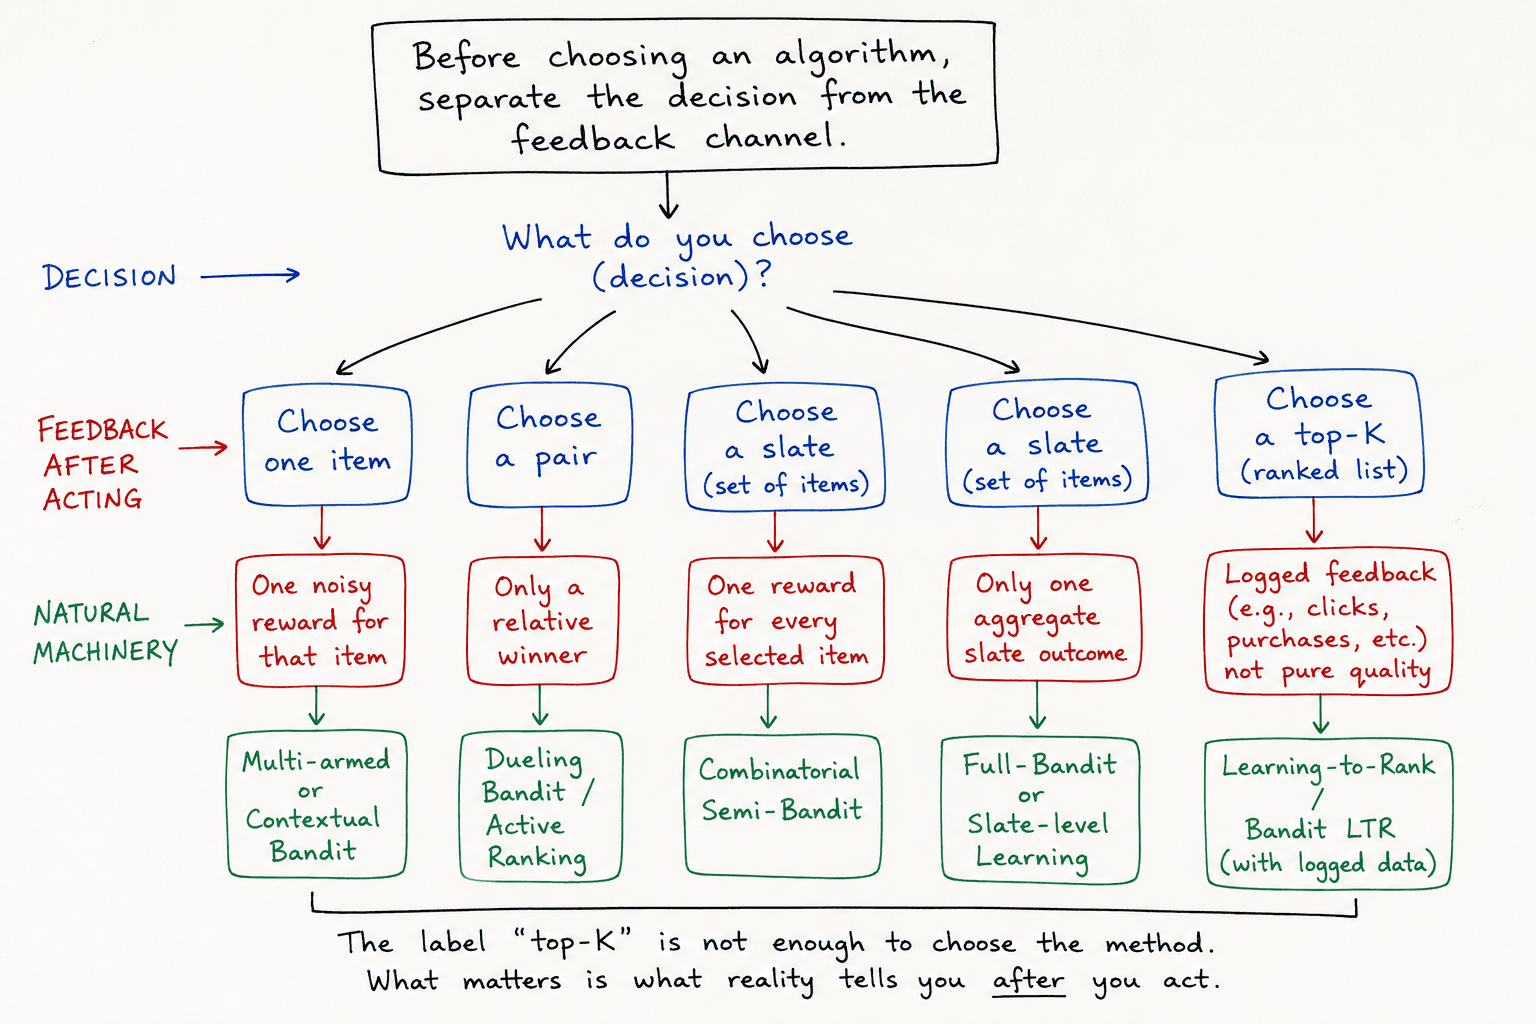
كلمة “top-K” لحالها مش كفاية لاختيار الطريقة. المهم: شو نوع الإشارة اللي بيرجعلك بعد القرار؟
الجزء الأول — الـ multi-armed bandit: نختار العشا
هالمسألة معروفة باسم multi-armed bandit. الاسم مستعار من آلات القمار، لكن الفكرة مفيدة بقرارات يومية ومنتجات كثيرة.
كل مطعم بيمثّل خياراً بنسميه arm، وكل زيارة إله تجربة أو pull، وجودة الوجبة هي المكافأة أو reward.
بس إنت بتتعشى بمطعم واحد بالليلة. بتعرف كيف كانت وجبتك هناك، وما بتعرف كيف كانت رح تكون بالمطاعم الثانية. وحتى هالوجبة الواحدة بتعطيك ملاحظة فيها ضجيج، مش حكماً نهائياً على جودة المطعم. هاد النقص بالمعلومة هو أساس المسألة.
الـ regret: ضريبة الجهل المخفية
لو السوشي هو فعلاً أفضل مطعم، وإنت أكلت بمكان أضعف، دفعت ضريبة مخفية. ممكن الليلة تكون لطيفة، بس مقارنة بأفضل خيار متاح، فوّتت على حالك جودة أفضل.
بنظرية الـ bandits، بنسمّي هالفرق regret:
هاي الخسارة التراكمية المتوقعة أثناء التعلّم. بتختلف عن مسألة تحديد أفضل خيار بعد انتهاء ميزانية التجارب. الترتيب واسترجاع أفضل K لاحقاً بقربوا من الهدف الثاني؛ والسياسة المناسبة ممكن تختلف حسب شو بدنا نحقق.
المعادلة بتجمع الفرق، بكل ليلة، بين متوسط جودة المطعم اللي اخترته ، وأفضل متوسط متاح . المتوسطان مجهولان للسياسة اللي عم تتعلّم، لكنهما بيسمحوا لنا نقيّم اختياراتها بالمحاكاة.
الخسارة ممكن تجي من اتجاهين. إذا التزمت بمطعم بدري، وجبة رامن موفقة ممكن تخليك تختار الفائز الغلط. وإذا ضليت تجرب للأبد، بتستمر تدفع ثمن وجبات أضعف بعد ما صار عندك دليل كافٍ على الخيار الأفضل.
سياسة الـ bandit هي قاعدة اختيار التجربة الجاية. عملياً، هي طريقة لتوزيع ميزانية التعلّم: أي معلومة ناقصة ممكن تغيّر القرار، وبتستحق كلفة تجربة إضافية؟
جرّب تاخد القرار بنفسك قبل ما نتعرّف على الخوارزميات.
اختار مطاعم لعشرات الليالي بالديمو. راقب أثر الثقة الزايدة بأول تجربة ناجحة، وقارنه بكلفة الاستمرار بتجربة مطاعم صار واضحاً إنها أضعف.
الدرس هو شكل المسألة: الاستكشاف مفيد بس طالما ممكن يغيّر القرار.
أربع طرق لتوزيع المحاولات
ε-greedy. أغلب الوقت، روح على المطعم اللي معدله الحالي أفضل. كل فترة، تجاهل ملاحظاتك وجرب عشوائياً.
هذا بحميك من غلطة مبكرة، بس عنده عادة غبية: حتى بعد ما يصير الفائز واضح، بضل يدفع ضريبة الاستكشاف.
UCB1 — التفاؤل وقت عدم اليقين. قيّم كل arm بـ:
واختار الخيار اللي عنده أعلى قيمة.
هون:
- هو عدد التجارب لحد الآن.
- هو عدد مرات تجربة الخيار رقم .
- هو متوسط المكافأة المرصودة للخيار رقم .
الحد الثاني،
هو علاوة الاستكشاف.
بيكون كبير لما صغير، وبيصغر كل ما يزيد الدليل. UCB مش عم يستكشف عشوائياً؛ هو عم يستكشف وين الغلط لسه ممكن يغيّر القرار.
KL-UCB. UCB1 بيستخدم حدّ ثقة عاماً للمكافآت المحدودة. نسخة KL-UCB هون بتستفيد من شكل توزيع Bernoulli: نجاح أو فشل.
إذا كانت النتيجة نقرة أو عدم نقرة، أو شراء أو عدم شراء، بنعطي الخيار أعلى معدل نجاح محتمل ضمن يحقق الشرط:
KL هون مقياس للاختلاف بين توزيعي Bernoulli: واحد بمعدل النجاح المرصود ، والثاني بالمعدل المقترح .
المعنى: خذ أعلى قيمة متفائلة لسه معقولة إحصائياً تحت بيانات Bernoulli اللي شفتها.
الانتقال من 2% إلى 5% إله دلالة إحصائية مختلفة عن الانتقال من 50% إلى 53%، رغم إن الفرق بالحالتين ثلاث نقاط مئوية. KL-UCB بياخد شكل التوزيع بالحسبان.
Thompson sampling: بنحتفظ بتوزيع احتمالي لجودة كل خيار، بدل الاكتفاء بمتوسط واحد. بكل جولة، بنسحب قيمة محتملة من كل توزيع، وبنختار صاحب أعلى قيمة مسحوبة.
المطعم اللي جرّبته مرات قليلة، توزيع الاحتمالات عنده واسع؛ مرات بتطلع منه سحبة عالية وبياخذ فرصة. المطعم اللي صار عندك دليل قوي إنه سيئ، توزيعه منخفض وضيق، فنادراً بفوز بالسحبة. ما في أمر منفصل بقول «استكشف هلأ»؛ الاستكشاف بطلع من عدم اليقين نفسه.
الحالة الصعبة هي لما أفضل مطعمين قريبين.
الاعتماد على أفضل متوسط حالي فقط ممكن يتوّج المطعم الغلط بسبب وجبة موفقة بالبداية. ε-greedy بتقلّل هالخطر بفرض تجارب عشوائية، لكنها بتواصل دفع كلفتها حتى لما تقل فائدتها. UCB وKL-UCB بتوجّه التجارب نحو الخيارات اللي لسه معرفتنا فيها محدودة، وThompson sampling بتعمل شيئاً قريباً من خلال السحب من التوزيعات الاحتمالية البعدية.
KL-UCB مناسبة للمكافآت اللي بنمثلها كتجارب Bernoulli، زي النقرة والشراء. لكن بالتطبيق الفعلي، بدنا ننتبه لتأخر وصول النتيجة، وانحياز موضع العرض، وتأثير تصميم الواجهة. إذا تجاهلنا هالعوامل، دقة الحساب ممكن تعطينا ثقة ما بتبررها البيانات.
افتح الكود: Bernoulli bandit مختصر
import math
import numpy as np


def bernoulli_kl(p, q):
    eps = 1e-12
    p = min(1 - eps, max(eps, p))
    q = min(1 - eps, max(eps, q))
    return p * math.log(p / q) + (1 - p) * math.log((1 - p) / (1 - q))


def kl_ucb(mean, pulls, t, c=3.0):
    if mean >= 1.0:
        return 1.0

    budget = (math.log(max(t, 2)) + c * math.log(math.log(max(t, 3)))) / pulls
    low, high = mean, 1.0 - 1e-12

    for _ in range(32):
        candidate = (low + high) / 2
        if bernoulli_kl(mean, candidate) <= budget:
            low = candidate
        else:
            high = candidate
    return low


def choose_arm(successes, pulls, t, policy, rng):
    unseen = np.flatnonzero(pulls == 0)
    if len(unseen):
        return int(rng.choice(unseen))

    means = successes / pulls

    if policy == "epsilon_greedy":
        return int(rng.integers(len(pulls))) if rng.random() < 0.10 else int(np.argmax(means))

    if policy == "ucb1":
        scores = means + np.sqrt(2.0 * np.log(t) / pulls)
        return int(np.argmax(scores))

    if policy == "kl_ucb":
        scores = np.array([kl_ucb(means[a], pulls[a], t) for a in range(len(pulls))])
        return int(np.argmax(scores))

    if policy == "thompson":
        samples = rng.beta(1 + successes, 1 + pulls - successes)
        return int(np.argmax(samples))


def update(successes, pulls, arm, reward):
    pulls[arm] += 1
    successes[arm] += reward
التجربة المفيدة غالباً هي اللي نتيجتها ممكن تغيّر قرارك.
السياق بيغيّر الجواب
اختصار المطعم بمتوسط جودة واحد مريح، لكنه ممكن يخفي أهم ما بالقرار.
غدا سريع، عزومة عيلة، غدا شغل، ضيوف جايين من برا، وعشا لحالك بيوم مطر مش نفس القرار. مطعم ممكن يكون غلط لواحدة وممتاز لثانية.
هاي فكرة contextual bandit: شوف الموقف أولاً، بعدين اختار.
بالصيغة الخطية البسيطة، بنمثّل الموقف بمتجه خصائص . ممكن يتضمن الحاجة لخدمة سريعة، أو مكان هادئ، أو كلفة منخفضة، أو ملاءمة للأطفال والمجموعات. ولكل خيار متجه معاملات بيمثّل علاقته بهالخصائص.
التوقع هو:
الضرب الداخلي بين المتجهين بيعطينا تقديراً لإجابة سؤال أدق من جودة المطعم بالمطلق:
قديش هذا المطعم مناسب لهذا الموقف؟
هيك بنستفيد من السياق. تجربة عشاء عائلي ناجحة بتعطينا معلومة عن ملاءمة المطعم لمواقف عائلية مشابهة، وغداء شغل سريع بيفيد بتقدير ملاءمته لمواقف العمل. النموذج بصير يميّز بين أنواع الزيارات بدل جمعها كلها بمتوسط واحد.
LinUCB بتجمع فكرة UCB مع هالنموذج الخطي. لكل خيار، بنحتفظ بإحصاءات تساعدنا نقدّر :
ومنهم:
وبنختار الخيار اللي عنده أعلى تقدير متفائل:
الحد الأول هو المكافأة المتوقعة بالسياق الحالي، والثاني بيمثّل عدم اليقين بتقديرها بهالجزء من فضاء الخصائص.
فالمجهول تغيّر. مش:
قديش هذا المطعم جيد؟
بل:
بأي مواقف هذا المطعم جيد؟
بالتطبيق الفعلي، لازم نعرف السياق قبل القرار. المعلومة اللي ما بتظهر إلا بعد الوجبة أو النقرة أو الشراء أو التوصيل أو الشكوى هي نتيجة نتعلّم منها، وما بصح نعاملها كأنها كانت متاحة لحظة الاختيار.
في الديمو، السياسة غير السياقية بتحتفظ بمتوسط واحد لكل مطعم. LinUCB بربط الاختيار بالموقف أولاً.
لما يكون المطعم مناسباً لسياق وضعيفاً بسياق ثاني، السياسة السياقية عندها فرصة تقلّل الخسارة، لأنها بتربط الاختيار بالمناسبة بدل خلط الزيارات المختلفة بمتوسط واحد.
افتح الكود: disjoint LinUCB بـ NumPy
import numpy as np


class DisjointLinUCB:
    def __init__(self, n_arms, dim, alpha=0.8, l2=1.0):
        self.alpha = alpha
        self.A = [l2 * np.eye(dim) for _ in range(n_arms)]
        self.b = [np.zeros(dim) for _ in range(n_arms)]

    def choose_arm(self, x):
        scores = []
        for A_a, b_a in zip(self.A, self.b):
            theta_a = np.linalg.solve(A_a, b_a)
            predicted_reward = x @ theta_a
            uncertainty = np.sqrt(x @ np.linalg.solve(A_a, x))
            scores.append(predicted_reward + self.alpha * uncertainty)
        return int(np.argmax(scores))

    def update(self, arm, x, reward):
        self.A[arm] += np.outer(x, x)
        self.b[arm] += reward * x


# x must contain only information known before the action.
# Example: [1, is_lunch, is_family_dinner, is_raining, mobile_user].
arm = policy.choose_arm(x_t)
reward = observe_reward(arm)
policy.update(arm, x_t, reward)
وأحياناً، ما عندك مكافأة رقمية جاهزة أصلاً.
بالرياضة، ممكن ما يكون عندك رقم مباشر لمهارة اللاعب، لكن بتقدر تشوف إنه A غلب B. ومع إجابات النماذج اللغوية، ممكن يكون أسهل على المقيّم يختار الأفضل بين إجابتين من إنه يعطي كل واحدة علامة جودة مطلقة.
هون بيتغيّر القرار ونوع المعلومة اللي بترجع منه: بتختار عنصرين للمقارنة، وبتشوف مين فاز.
الجزء الثاني — الترتيب بالمقارنات الزوجية: مين يلعب مع مين؟
ثمانية لاعبين. ما عندك سجل أداء، ولا رقم جاهز لمهارة كل واحد.
بتقدر تنزّل أي لاعبين يلعبوا وتشوف مين فاز.
المباراة مقارنة فيها ضجيج: اللاعب الأقوى غالباً بيفوز، لكن النتيجة مش مضمونة. وكل ما تقاربت مهارة اللاعبين، صار أصعب نتوقع الفائز من فرق المهارة وحده.
مع لاعب، عدد الأزواج الممكنة من رتبة . مقارنة كل لاعب بكل لاعب بتصير مكلفة حتى بأعداد محدودة، ومع ملايين العناصر بتتجاوز ميزانية المنتج بسهولة.
فالتحدي مش بس نبني جدول ترتيب من المباريات؛ لازم نقرر أي مباراة إضافية ممكن تفيدنا.
إذا لاعب جديد غلب بطل العالم، لعبه ضد الضعاف بعدين ما بعلمك كثير. المقارنات المفيدة بتكون حوالين الحدود اللي لسه مش محسومة.
مين لازم يلعب المباراة الجاية؟
لسه عم نحاول نرتّب العناصر، لكن نتيجة المقارنة نفسها غير مؤكدة. بالترتيب التقليدي بنفترض إن المقارنة موثوقة؛ هون العنصر الأفضل بيفوز غالباً، مش دائماً.
القرار هو اختيار زوج، والمعلومة الناتجة بت واحد: مين فاز؟ ما عندنا علامة مطلقة لمهارة أي من اللاعبين.
الافتراض البنيوي القياسي هو Bradley-Terry.
بنفترض إن لكل عنصر درجة مهارة خفية، وإن احتمال الفوز بيعتمد على الفرق بين الدرجتين:
إذا الدرجتان متساويتان، احتمال الفوز 50/50. وإذا الفرق كبير، بنقترب من نتيجة شبه مؤكدة. قيمة كل درجة بالمطلق مش هي المهمة؛ المهم الفرق بينهما.
فائدة المقياس المشترك إنه بربط المعلومات بين المقارنات. نتائج A مع B، وB مع C، بتساعدنا نقدّر احتمال فوز A على C حتى قبل ما يتواجهوا.
الصعوبة بتمييز الفروقات الصغيرة. تقريباً، التمييز بين درجتي مهارة الفرق بينهما ، بثقة ، بيحتاج:
مقارنات.
الفروقات الكبيرة بتنحسم بسرعة. المنافسات المتقاربة جداً بتاكل الميزانية.
من نتائج المباريات إلى تقديرات المهارة
التقدير الدفعي (batch fit). خذ كل المباريات وقدّر درجات Bradley–Terry اللي بتخلي النتائج المرصودة أكثر احتمالاً.
إذا A غلب B كثير، التقدير بدفع درجته لفوق بالنسبة لـB. وإذا B غلب C كثير، بصير عندنا دليل عن B بالنسبة لـC. المقياس المشترك بربط هالمعلومات وبيعطينا تقديراً لـA مقابل C حتى لو ما لعبوا، بشرط إن افتراض النموذج مناسب.
الكود تحت بيحدّث التقديرات على كل المباريات دفعة واحدة. بنبلّش بقوة موجبة ومتساوية لكل لاعب. وبكل تكرار بنسأل: مع تقديرات قوة المنافسين الحالية، قديش لازم تكون قوة اللاعب حتى تفسّر عدد انتصاراته؟
بعد كل جولة حساب، بنوحّد المقياس. Bradley–Terry بهمّه تناسب القوى؛ ضرب كل القيم بنفس الثابت ما بغيّر احتمالات المباريات.
رتّب تقديرات المهارة وبيطلع معك الجدول. بس إعادة حساب النموذج من الصفر بعد كل مباراة بتصير مكلفة لما يكبر عدد اللاعبين.
التحديث التدريجي: Elo. نفس الفكرة بروح أبسط: احتفظ بتقييم لكل لاعب وحدّثه بعد كل مباراة.
الفوز برفع تقييم الفائز وبيخفض تقييم الخاسر، وحجم التعديل بيعتمد على مدى توقع النتيجة. الفوز على بطل العالم بيحمل معلومة أكبر من الفوز على مبتدئ، والخسارة أمام لاعب أضعف بكثير بتستدعي مراجعة أكبر للتقييم.
صيغة واحدة لهالتحديث هي خطوة logistic regression. إذا غلب :
هنا هو احتمال الموديل قبل المباراة إن يغلب . التحديث هو المفاجأة: .
لو كان مرشحاً بقوة للفوز، الحركة صغيرة. لو فوزه كان مفاجأة، الحركة أكبر.
افتح الكود: Bradley–Terry batch fit وElo online
import numpy as np


def fit_bradley_terry_mm(wins, iterations=100, eps=1e-9):
    """
    wins[i, j] is the number of times item i beat item j.
    Returns log-strengths; sorting them gives the Bradley–Terry ranking.
    """
    wins = np.asarray(wins, dtype=float)
    pair_games = wins + wins.T
    total_wins = wins.sum(axis=1)
    n_items = len(wins)
    strength = np.ones(n_items)

    for _ in range(iterations):
        updated = strength.copy()
        for i in range(n_items):
            denominator = 0.0
            for j in range(n_items):
                if i != j and pair_games[i, j] > 0:
                    denominator += pair_games[i, j] / (strength[i] + strength[j])

            if denominator > 0:
                updated[i] = max(total_wins[i], eps) / denominator

        # Bradley–Terry is identifiable only up to an additive constant in log-space.
        updated /= np.exp(np.mean(np.log(np.maximum(updated, eps))))
        strength = updated

    return np.log(np.maximum(strength, eps))


def elo_update(rating, i, j, winner, learning_rate=0.25):
    """One online logistic-regression step after i versus j."""
    p_i_wins = 1.0 / (1.0 + np.exp(-(rating[i] - rating[j])))
    target_i = 1.0 if winner == i else 0.0
    delta = learning_rate * (target_i - p_i_wins)

    rating[i] += delta
    rating[j] -= delta
    return rating


# Batch: scores = fit_bradley_terry_mm(wins)
# Online: rating = elo_update(rating, i, j, winner)
حلقة العمل بتصير:
قدّر المهارات من المباريات → اقرأ الترتيب بفرزها → جدوِل المباراة الجاية.
أي مباريات بتستحق التجربة؟
الأفضل نختار مباراة نتيجتها ممكن تغيّر ترتيباً لسه مش محسوم.
مباراة غير متكافئة غالباً بتأكّد اللي الموديل أصلاً مصدّقه. لو #1 غلب #8، الجدول بالكاد بيتحرك.
المباراة المتقاربة مختلفة. النتيجتين معقولتين، وكل نتيجة بتعلّمك شيء عن ترتيب محلي لسه مش محسوم.
جدولة مفيدة بتختار أزواجاً متقاربة ما لعبت بما يكفي لنعرف ترتيبها.
Random تختار أي زوج.
Round-robin تختار الزوج الأقل لعباً، .
Ladder تقارن الجيران في الجدول الحالي.
Active بتستخدم قاعدة تقريبية بتفضّل أزواجاً متقاربة وقليلة المباريات؛ وبنسخة top-K بنركّز على حدود المجموعة الحالية:
المنحنى بيعرض متوسط استرجاع أفضل خمسة (top-5 recall) عبر بطولات محاكاة متكررة: أي نسبة من أفضل خمسة لاعبين فعلياً ظهرت ضمن الخمسة اللي اختارهم تقديرنا؟ المقياس من صفر لواحد. ركّز على بداية المنحنى، لأن زيادة ميزانية المباريات بتعطي السياسات وقتاً أطول لتعويض أخطائها.
زر أعد التجارب بكرّر المقارنة، وزر عدد التجارب ببدّل بين 48 و96 بطولة. الخطوط للمتوسط، والتظليل للاختلاف بين التجارب. وإذا بدك تختار المباريات بإيدك، ارجع لديمو جدول الدوري اللي قبل.
المباريات الواضحة بتحسّسك بالأمان. نادراً بتغيّر شيء.
ليش مجموعة المرشحين لازم تكون أوسع من K
كثير مرات ما بدك الترتيب كله. بدك أفضل K.
لو ، بنهتم خصوصاً بحدّ الاختيار الحالي حول المركز 100، أو الـ cutline: المنطقة اللي لسه مش واضح فيها مين لازم يدخل المجموعة ومين يطلع منها.
ممكن يغريك تقارن فقط بين العناصر الموجودة حالياً ضمن أفضل K، لكن هيك بتوقع بثلاث مشاكل:
- عنصر بيستحق يكون ضمن المجموعة، لكنه مصنّف مؤقتاً عند K+1، ما رح ياخد فرصة يرجع.
- بعض المقارنات داخل المجموعة بتكون محسومة تقريباً، فما بتساعدنا نراجع عضويتها.
- عزل المجموعة عن بقية العناصر بضعف الأدلة اللي بتربط المركز K بمنافسيه خارجها.
الحل إننا نحتفظ بمجموعة مرشحين حول حدّ الاختيار. كل عنصر لسه تقدير جودته غير المحسوم بيسمح له بمنافسة المركز K بيظل ضمن المجموعة. وبنستبعده لما يصير الدليل كافياً، مش لمجرد إن ترتيبه الحالي أقل بدرجة.
افتح الكود: active matching حول cutline
import numpy as np


def candidate_band(scores, score_se, k, z=1.96):
    """
    Keep candidates whose confidence intervals overlap the current K-th item.
    score_se can come from a Hessian approximation, a bootstrap, or a posterior.
    """
    order = np.argsort(-scores)
    cutline_item = order[k - 1]
    cutline_low = scores[cutline_item] - z * score_se[cutline_item]
    cutline_high = scores[cutline_item] + z * score_se[cutline_item]

    lower = scores - z * score_se
    upper = scores + z * score_se
    band = np.flatnonzero((upper >= cutline_low) & (lower <= cutline_high))

    # Keep enough local rivals even when the intervals are overconfident early on.
    local = order[max(0, k - 4):min(len(scores), k + 4)]
    return np.unique(np.concatenate([band, local]))


def choose_active_pair(scores, score_se, pair_games, candidates):
    """Prefer uncertain, close pairs inside the cutline candidate band."""
    best_pair = None
    best_value = -np.inf

    for left in range(len(candidates)):
        for right in range(left + 1, len(candidates)):
            i, j = candidates[left], candidates[right]

            # Lightweight heuristic. A full BTL fit should use uncertainty
            # of the difference s_i - s_j, including covariance.
            pair_se = np.sqrt(score_se[i] ** 2 + score_se[j] ** 2)
            standardized_gap = abs(scores[i] - scores[j]) / (pair_se + 1e-9)
            boundary_value = 1.0 / (1.0 + standardized_gap)
            pair_uncertainty = 1.0 / np.sqrt(pair_games[i, j] + 1.0)
            value = boundary_value * pair_uncertainty

            if value > best_value:
                best_value = value
                best_pair = (i, j)

    return best_pair


# At every round:
# band = candidate_band(elo_rating, score_se, k=100)
# i, j = choose_active_pair(elo_rating, score_se, pair_games, band)
# winner = observe_comparison(i, j)
# elo_rating = elo_update(elo_rating, i, j, winner)
الكود بيوضح المبدأ: احتفظ بمرشحين على جانبي الحد، واستخدم تقدير عدم اليقين المتاح بالنموذج حتى تحدد مين لسه بيستحق المقارنة.
مع 10,000 لاعب، في حوالي خمسين مليون زوج ممكن. المقارنة الشاملة بتستهلك ميزانية هائلة من البداية.
بدل هيك، استخدم تقديراً بيتحدّث بعد كل مباراة، زي Elo، وجدولة متكيّفة بتركّز حول تقييم صاحب المركز K. المقياس هون recall@100: نسبة أفضل مئة لاعب فعلياً اللي دخلوا أفضل مئة حسب تقديرنا.
بهالمحاكاة، الجدولة العشوائية بتصرف مباريات كثيرة على لاعبين بعيدين عن حد الاختيار. الجدولة المتكيّفة بتسترجع معظم أفضل مئة لاعب بعشرات آلاف المباريات، بدل المرور على كل الأزواج الخمسين مليوناً.
ميزتها بهالإعداد إنها بتركّز على العناصر اللي عضويتها بالمجموعة لسه غير محسومة. عدد المباريات المطلوب بيتأثر بفروق المهارة حول المركز 100، وضجيج النتائج، وملاءمة النموذج، وقاعدة إيقاف البحث.
الجزء الثالث — Combinatorial semi-bandits: نختار مجموعة كاملة
هلأ بنوسّع القرار: بدأنا بخيار واحد، وانتقلنا لزوج، وهون بدنا نختار مجموعة كاملة (slate). هاد شائع بالمنتجات: صفحة فيها عشرة منتجات، أو اثنا عشر مقتطفاً، أو عشرون مرشحاً، أو مجموعة توصيات.
مقارنة كل زوج بكل زوج إلها فاتورة O(n²): مئة عنصر بيعطوك 4,950 زوجاً ممكناً. بس الترتيب النشط اللي شفناه ما بحتاج يشتري كل المقارنات. الطريقة الجاية بتغيّر شغلة ثانية: قديش معلومة بترجع من القرار الواحد.
بالجزء الثاني وفّرنا بالمقارنات عن طريق التركيز حول حدّ الاختيار. هون بنغيّر مقدار المعلومة اللي بترجع من المحاولة: بنختار مجموعة، وبنراقب نتيجة كل عنصر اخترناه، وبنحدّث تقديرات هالعناصر.
هذا هو combinatorial semi-bandit: بتختار مجموعة كاملة، وبترجعلك ملاحظة منفصلة عن كل عنصر اخترته.
من وين بنجيب تقدير الجودة؟
بنرجع لنفس مبدأ التفاؤل تحت عدم اليقين، لكن لاختيار مجموعة كاملة.
اعطِ كل عنصر تقديراً للمكافأة وعلاوة لعدم اليقين، وبعدين اختار أفضل K حسب المجموع المتفائل:
هون هو تقدير المكافأة الحالي، و هو عدد المرات اللي وصلتنا فيها ملاحظة مفيدة عن العنصر رقم .
تقدير مكافأة عالٍ بياخذ مقعداً بالقائمة. وعدم يقين عالٍ ممكن ياخذ مقعداً كمان. بكل جولة بنختار أعلى K، بنراقب نتيجة كل عنصر مختار، وبنحدّث هالعناصر.
بواجهة منتج حقيقية، افتراض إن مكافأة القائمة مجرد مجموع مكافآت عناصرها ممكن ينكسر: مكان العرض بأثر، وعنصر ممكن يسحب الانتباه من الثاني. الحلقة مفيدة، بس ضماناتها بتعتمد على افتراضات لازم نفحصها.
السؤال الصعب: من وين إجت ؟
- مكافأة مباشرة: بتوصلنا قيمة لكل عنصر، زي نقرة، أو وقت مشاهدة، أو نتيجة اختبار. هون بنستخدم السياسة مباشرة.
- مقارنات فقط: المتاح إن A غلب B. وبما إن Comb-UCB بتحتاج تقديراً لكل عنصر، لازم نضيف خطوة تحوّل نتائج المقارنات لهالتقديرات.
بالحالة الثانية، إنت بتبني مؤشراً بديلاً للمكافأة من أحكام المقارنة.
اعمل بطولات صغيرة: اطلب من المقيّم يرتّب 10–20 عنصراً، وحوّل الترتيب لانتصارات زوجية، وقدّر Bradley–Terry زي الجزء الثاني. هيك بتربط المقارنات المحلية بتقديرات على مقياس مشترك.
هذا التقدير مش حقيقة مرجعية. هو أفضل قراءة حالية لأحكام المقيّم، وبنستعمله لنقرر وين نصرف الجولة الجاية.
يعني بنستخدم طريقة الجزء الثاني لتقدير الجودة، وطريقة الجزء الثالث لاختيار المجموعة اللي رح نطلب تقييمها بالمحاولة الجاية.
افتح الكود: combinatorial UCB مع per-item rewards
import numpy as np


class CombinatorialUCB:
    def __init__(self, n_items, exploration=1.0):
        self.reward_sum = np.zeros(n_items)
        self.pulls = np.zeros(n_items, dtype=np.int64)
        self.exploration = exploration

    def select_slate(self, k, t):
        means = np.divide(
            self.reward_sum,
            self.pulls,
            out=np.zeros_like(self.reward_sum),
            where=self.pulls > 0,
        )
        bonus = np.full_like(means, np.inf)
        seen = self.pulls > 0
        bonus[seen] = self.exploration * np.sqrt(np.log(max(t, 2)) / self.pulls[seen])
        scores = means + bonus

        # argpartition avoids sorting every item when k << n_items.
        slate = np.argpartition(scores, -k)[-k:]
        return slate[np.argsort(-scores[slate])]

    def update(self, slate, rewards):
        self.pulls[slate] += 1
        self.reward_sum[slate] += np.asarray(rewards)


slate = policy.select_slate(k=12, t=round_number)
rewards = observe_per_item_rewards(slate)  # one reward for every selected item
policy.update(slate, rewards)
الديمو التالي بقارن بين طريقتين مختلفتين للحصول على المعلومة.
Comb-UCB هون بياخذ مكافأة مباشرة لكل عنصر بالقائمة المختارة. Bradley–Terry بياخذ نتيجة مقارنة واحدة بكل مواجهة، ومنها ببني ترتيباً مشتركاً. المقارنة بين قناتين مختلفتين للمعلومة؛ عدد الجولات لحاله مش مقياساً عادلاً للكلفة.
المثال العملي: نطلع الجمل اللافتة من مراجعات الزبائن
خلينا نطبق الفكرة على مهمة فعلية: عندك آلاف مراجعات الزبائن، وبدك تختار منها مقتطفات بتستحق القراءة.
ما في مكافأة طبيعية لكل مقتطف: لا نقرة، ولا نتيجة اختبار، ولا رقم جودة جاهز. الإشارة المتاحة هي حكم المقيّم.
سياسة الاختيار بتقرر أي مقتطفات تستاهل تقييماً إضافياً. وBradley–Terry بحوّل الأحكام لتقديرات قابلة للمقارنة.
candidates = extract_snippets(reviews)        # large pool, no scores yet
score = {c: 0.0 for c in candidates}          # Bradley-Terry latent reward
pulls = {c: 0   for c in candidates}
pairs = []

for t in range(1, rounds + 1):
    # 1. SELECT an optimistic, diverse slate using current BT scores
    ucb   = {c: score[c] + C * sqrt(log(t + 1) / (pulls[c] + 1)) for c in candidates}
    slate = top_k_constrained(ucb, k=K, max_per_type=...)   # <= K, capped per type

    # 2. JUDGE: one listwise ranking of the slate -- a small tournament
    ranking = llm_rank(slate)               # "order these from best to worst"

    # 3. CALIBRATE: ranking -> pairwise wins -> refit Bradley-Terry
    pairs += ranking_to_pairs(ranking)      # i beats j for every i ranked above j
    score  = fit_bradley_terry(pairs)

    # 4. only judged items count as pulled
    for c in slate:
        pulls[c] += 1

best = sorted(candidates, key=lambda c: score[c], reverse=True)[:K]
شغلتان بتسمحوا لنا نخفف كلفة المقارنة الشاملة من رتبة :
الاختيار بـUCB بصرف التقييم وين الترتيب لسه مش محسوم، وبخفّف الإنفاق على المرشحين اللي صار ضعفهم واضحاً.
تقييم قائمة دفعة واحدة بحوّل طلباً واحداً لقيود كثيرة: ترتيب K عناصر بيعطي نتيجة زوجية. هاي نتائج مرتبطة ببعض، مش مشاهدات مستقلة؛ عدّها كعينات مستقلة بنفخ الثقة.
جربت الطريقة على عينة من 1,500 مراجعة. بعد التصفية لمراجعات الأربع والخمس نجوم واستخراج المقتطفات، بقي عندي 114 جملة مرشحة. استخدمت وشغّلت 11 جولة.
مقارنة الكلفة بالطريقة الشاملة:
| مقارنة كل الأزواج | هالتشغيل | |
|---|---|---|
| عدد المرشحين | 114 | 114 |
| مرور شامل واحد | 6,441 زوجاً | ما احتجناه |
| استدعاءات المقيّم المكلفة | آلاف | 22 |
| القيود الزوجية المستخلصة | — | غير محسوم؛ شوف الملاحظة تحت |
| المقتطفات الضعيفة | بتنقارن بكل الأحوال | تقيّمت 0–1× |
الملاحظة الأصلية سجّلت 2,582 قيداً زوجياً. بس 22 ترتيباً، كل واحد فيه 14 عنصراً كحد أقصى، بيعطوا بحد أقصى . إذا كان في قوائم أكبر أو مقارنات إضافية أو سجل متراكم، لازم يبان بسجل التشغيل. المثال بيوضح حلقة الاختيار؛ أرقام الكلفة لسه بدها مطابقة مع السجل.
هاي بعض أطرف المقتطفات اللي اختارها، مرتبة حسب تقدير Bradley–Terry. تركتها بلغتها الأصلية:
| تقدير Bradley–Terry | مرات التقييم | المقتطف الأصلي |
|---|---|---|
| +4.05 | 11× | "3.6 Roentgen. Not great, not terrible." |
| +3.16 | 9× | "There is a reason more people have Amazon Prime than own guns in the United States." |
| +3.09 | 8× | "Thanks Amazon — if it was up to you, I would never have to leave my house. Unfortunately there are some inconveniences in my life, such as work." |
| +2.86 | 11× | "I bought my uncle a penis enlargement book for 'Secret Santa'… Hoping this rating grows to five stars, depending on results." |
| +2.28 | 9× | "Only problem is they don't come through my door and start performing." |
| +5.22 | 1× | "…the best thing that ever happened to me. Family comes second." |
آخر صف بيورجيك نوع الغلط اللي بدنا الاستكشاف يكشفه.
الجملة بأعلى تقدير بعد حكم واحد بس. هاد بخليها مرشحة لمزيد من التقييم، مش فائزة محسومة. المفروض سياسة UCB تعطيها فرصة اختبار ثانية قبل ما نعتمد ارتفاع تقديرها.
الجملة اللي تقيّمت 11 مرة إلها أدلة أكثر من جملة تقيّمت مرة واحدة، بس تكرار حكم نفس المقيّم مش ضمان للصحة. أعلى تقدير وأعلى تقدير بتثق فيه سؤالان مختلفان.
وبالمنتج الحقيقي في سؤال أسبق: شو طلبت من خوارزمية التحسين تحسّن أصلاً؟
بمحاولة سابقة، قبل فلتر الأربع والخمس نجوم، اختار النظام مقتطفات غاضبة عن تجارب توصيل سيئة. هو ما اكتشف «المضحك» كصفة مستقلة؛ اتبع التصفية وتعليمات المقيّم.
شو بنعتبره «لافتاً» أو «مضحكاً» داخل باختياراتنا للتصفية والتقييم. خوارزمية التحسين بتشتغل ضمن هالاختيارات، وما بتحدد معناها لحالها.
ملحق: وين بتفيد RUCB؟
Bradley–Terry بيمثّل العناصر على مقياس مشترك واحد. هاد مصدر قوته، وافتراض لازم ننتبه لحدوده.
إذا التفضيلات بتشكّل دورة — A بيفضَّل على B، وB على C، وC على A — مقياس الجودة الواحد ما بقدر يمثّلها كلها. وقتها بنحتاج نتعامل مع احتمالات المقارنة مباشرة، ونحدد شو بنقصد بالفائز.
RUCB بتشتغل على احتمالات الفوز الزوجي، لكن تحليلها المعتاد بفترض وجود فائز كوندورسيه: عنصر بغلب كل منافس باحتمال أكبر من النصف. دورة A يغلب B وB يغلب C وC يغلب A ممكن تعني إنه هالفائز مش موجود. وقتها لازم نختار هدفاً ثاني، زي فائز Copeland، ونستخدم طريقة مناسبة إله.
محطات من تاريخ الـ bandits
الأفكار تراكمت عبر عقود، وكل خطوة وسّعت طريقة تعاملنا مع القرار والمعلومة الناقصة:
- 1933 — Thompson: اختيار كل فعل بحسب احتمال إنه الأفضل؛ الفكرة المعروفة اليوم باسم Thompson sampling.
- 1952 — Robbins: صياغة الموازنة بين استغلال المعرفة الحالية والتجريب لاكتساب معرفة جديدة.
- 1952 — Bradley & Terry: مقياس مشترك لمهارة العناصر يفسّر احتمالات الفوز.
- 1979 — Gittins: سياسة قائمة على مؤشرات للـ bandit البايزي مع خصم المكافآت المستقبلية.
- 1985 — Lai & Robbins: حدود نظرية للخسارة التراكمية، ومعدلات نمو لوغاريتمية من نوع .
- 2002 — Auer, Cesa-Bianchi & Fischer: تحليل UCB1 وضماناتها بعد عدد محدود من المحاولات.
- 2009–2012 — dueling bandits: التعلّم من فوز عنصر على آخر بدل مكافأة رقمية مباشرة.
- 2010 — contextual bandits: تطبيقات تربط الخيار المناسب بسياق معروف قبل القرار.
- 2013 — combinatorial semi-bandits: اختيار مجموعة وملاحظة مكافأة كل عنصر مختار.
هالمحطات بتورجي اتساع أنواع المسائل: خيار منفرد، ومقارنة زوجية، وقرار مرتبط بسياق، ومجموعة كاملة من العناصر.
شو طلع معنا؟
الخيط المشترك إننا بنعرف الخيارات المتاحة، لكن ما بنعرف بدقة قيمتها. والملاحظات اللي بتكشف هالقيمة إلها كلفة. عشان هيك نوع القرار والمعلومة اللي بترجع منه بحددوا شكل المسألة.
إذا بتختار عنصراً واحداً وبتشوف مكافأته، عندك صيغة الـ multi-armed bandit. إذا المعلومة مقارنة بين عنصرين، بتدخل بمسائل dueling أو ranking، وBradley–Terry واحدة من طرق بناء تقدير مشترك منها. وإذا بتختار مجموعة وبتشوف نتيجة كل عنصر فيها، عندك combinatorial semi-bandit.
المثال بيتغيّر: مطعم، أو مباراة، أو مجموعة توصيات.
وبكل مرة، عم تختار أي معلومة ناقصة بتستحق كلفة التعلّم عنها.