
مقدّمة: كيف تطوّرت طريقة شغلنا مع الـ AI
البرمجة مع الذكاء الاصطناعي بتغيّر إيقاع الشغل. بكتب بسرعة، وبعرّفك على مكتبات ما استعملتها، وبساعدك تفك كود غريب عليك. وبعدين بعمل غلطة سخيفة وببني فوقها ثلاث طوابق. لسه بدك تفحص المتطلبات والحالات الطرفية والمعمارية. السؤال المثير: بأي نوع من الشغل ممكن تخفّف هالمراقبة المستمرة؟
في نوع من الشغل بتظهر فيه هالإمكانية بوضوح: المسائل المحدودة النطاق (bounded problems). ممكن تحتاج تفكيراً متقدماً وخبرة عميقة، من غير ما تتطلب بناء نظام إنتاج كامل. تصميم خوارزمية، أو كتابة مقال، أو إعداد مادة تعليمية، كلها مهام ممكن تكون صعبة جداً رغم وضوح حدودها.
في تجارب بتورجي الإمكانية. أنظمة الذكاء الاصطناعي المركّبة بتجمع نماذج وأدوات ومكوّنات ثانية؛ والـ agents طريقة لتنظيم بعض هالأنظمة، مش اسم ثاني إلها كلها. AlphaCode وصل تقريباً لمستوى المتسابق الوسطي بالمسابقات اللي قيّموه عليها. هاي نتائج لمهام محددة، مش علامات موحّدة للاستقلالية العامة.
بعلاقتنا اليومية مع أدوات البرمجة، لسه الغالب هو التعاون المباشر: إنت بتحدد الخطوة الجاية، والأداة بتنفّذ. السؤال إذا بنقدر نعطيها مسؤولية أوسع عن سير المحاولة نفسها.
أنظمة زي AlphaEvolve قدّمت تقسيماً مختلفاً للشغل. الإنسان بحدد المسألة وطريقة تقييم الحل، والنموذج بقترح تعديلات على الكود، والنظام بشغّلها وبقيّمها وبحتفظ بالنتائج المفيدة. هيك بتدخل اقتراحات النموذج بحلقة بحث تطوّري، ضمن مهمة وصلاحيات وقواعد تقييم محددة مسبقاً.
بورقة الاستكشاف والاكتشاف الرياضي على نطاق واسع، بوغدان جورجييف وخافيير غوميز سيرانو وتيرينس تاو وآدم زولت واغنر بوصفوا استعمال AlphaEvolve بمسائل بناء رياضي. خبرة الإنسان بعدها أساسية باختيار المسائل وفهم النتائج. اللي بشدّني هو قديش من البحث بقدر يصير بين تدخل بشري والثاني.
من تصميم الخوارزمية إلى استقلالية الـ agent
رح نمشي بثلاث مقاربات لحل المسائل المحدودة، ونشوف كيف ممكن تكمل بعضها. مثالنا طول المقال هو رصّ الدوائر (circle packing): عندك مربع وبدك تحط داخله k دائرة، من غير تداخل، بحيث يكون مجموع أنصاف أقطارها أكبر ما يمكن.
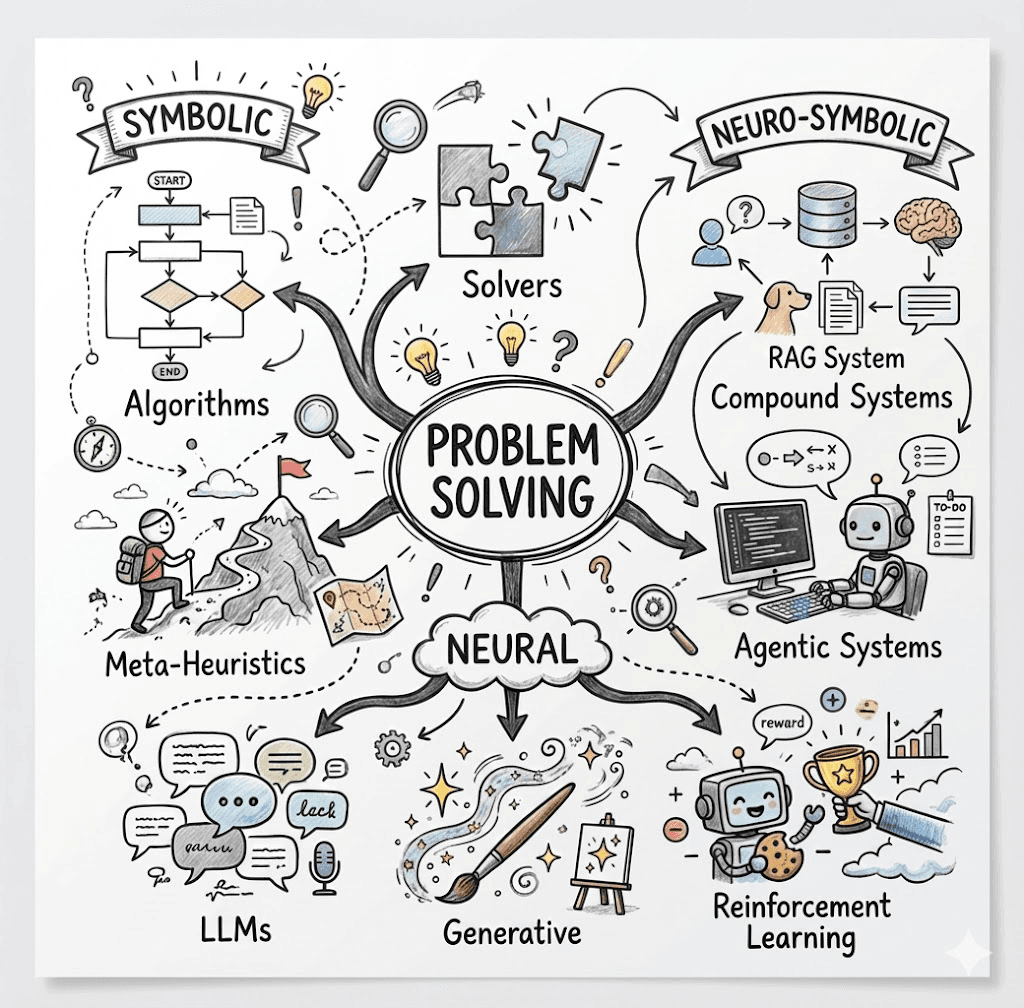
في ثلاثة أدوار مفيد نفصل بينهم: بحث وتحسين بنكتب قواعده بإيدنا، واقتراحات متعلّمة بطلعها نموذج، ونظام هجين بواجه الاقتراحات بفحوص قابلة للتنفيذ. هاي مقاربات متداخلة، مش عصور تاريخية كل واحد ألغى اللي قبله. استقلالية الـ agent بتغيّر مين بنظّم البحث بينها.
المقاربة 1: الطرق الرمزية الكلاسيكية (البحث والتحسين)
هاي المقاربة مألوفة من منهج بوليا لحل المسائل، اللي عرضه بكتابه How to Solve It سنة 1945: افهم المسألة، ضع خطة، نفّذها، وراجع النتيجة. برصّ الدوائر، بتسأل عن القيود والأنماط الممكنة، وبتصمّم استراتيجية، وبعدين بتحوّلها لكود. بمسائل زي ترتيب قائمة أو إيجاد أقصر مسار، ممكن توصل لخوارزمية واضحة وفعّالة.
وبعدين بتصطدم بالحيط.
وضوح حدود المسألة ما بعني إن البحث عن حلها سهل. بعض عائلات مسائل التحسين NP-hard، لكن هاد ما بعني إن كل حالة منها بتحتاج تجربة كل الاحتمالات. سؤال P مقابل NP لسه مفتوح، وصعوبة أسوأ الحالات ما بتلغي إمكانية الاستفادة من بنية المسألة، أو استبعاد أجزاء من البحث، أو استخدام حلول تقريبية. مسألتنا ذات الـ26 دائرة هي مسألة تحسين مستمر وغير محدّب؛ عدّ الترتيبات أو وصفها بـNP-hard لحاله ما بثبت صعوبتها. عملياً، إيجاد ترتيب ممتاز أسهل من إثبات إنه ما في ترتيب أفضل منه.

في أكثر من طريقة نتقدم من غير ما نثبت الحل الأمثل من أول محاولة. خلينا نفصل بين شغلتين:
خوارزميات التقريب. لبعض صيغ المسائل، الخوارزمية بتعطيك حداً يربط جودة جوابها بالأمثل. الضمان بخص الصياغة وافتراضاتها. تجربة رصّ الدوائر هون ما معها ادعاء بضمان من هالنوع.
التحسين وأساليب البحث العامة. تسلّق التل، والخوارزميات الجينية، والتلدين المحاكى بتبحث عن حلول جيدة ضمن ميزانية محددة. والتحسين العددي المحلي بساعدنا نصقل الحل. لكن ضمانات هالطرق مختلفة: البرمجة الخطية بتسمح بإيجاد الحل الأمثل لهدف خطي ضمن قيود خطية، بينما البحث المحلي بمسألة الرصّ غير المحدّبة ممكن يعلق عند حل ما بقدر يحسّنه بخطواته الحالية. كلمة «تحسين» لحالها ما بتعطينا نفس الضمان بالحالتين.
رح أسمّي الخوارزميات والحلّالات اللي بنحددها مباشرة طرقاً صريحة. بعضها حتمي، والخوارزميات الجينية والتلدين المحاكى عادةً فيهم عشوائية. الكود المكتوب بخلّي الإجراء قابلاً للفحص؛ ما بخلّي النتيجة صحيحة أو مثالية تلقائياً.
هالطرق لسه أدوات أساسية، لكنها بتعتمد على خبرة بتصميم الخوارزميات والبرمجة والرياضيات والتحسين. وحتى مع هالخبرة، الوصول لحل ممتاز ممكن يظل صعباً.
الميزة الفعلية: بتقدر تفحص آلية البحث، وتختبرها، وتحلّل كلفتها، وتثبت اللي افتراضاتها بتسمح تثبته. بالخوارزمية الجينية، الطفرة والانتقاء واضحين بالكود. هالوضوح بساعدك تصلح الإجراء حتى لو ما بتقدر تضمن إنه رح يلاقي أحسن رصّة.
المشكلة: بتطلب منك تكون الخبير. لازم تعرف أو تكتشف المقاربة الصح.
المقاربة 2: تعلّم الآلة الصرف (الحدس المتعلَّم)
الفكرة مغرية: بدل ما نصمّم خطوات الحل كلها، ندرّب شبكة عصبية على أمثلة كثيرة ونخليها تتعلّم الأنماط. بما إن الحدس بيساعدنا بحل مسائل صعبة، ليش ما نجرب نستفيد من حدس متعلَّم عند النموذج؟
كمثال بصري، طلبت من Gemini 3 يولّد صورة لرصّ الدوائر. ما بقدر أعرف من الصورة إذا شاف أمثلة مشابهة بالتدريب. اللي بقدر أفحصه هو الناتج:
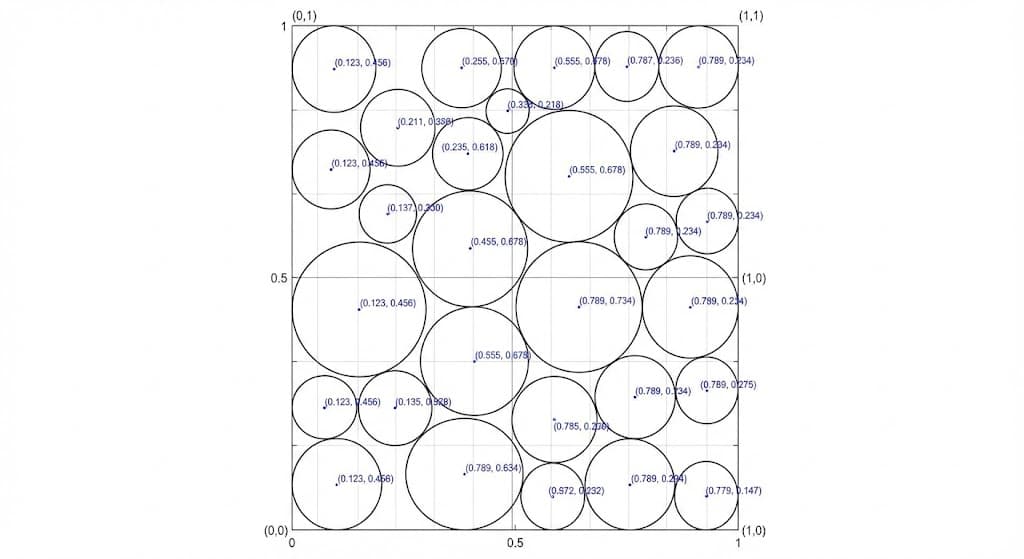 الصورة: محاولة Gemini لرصّ الدوائر. توزيع حدسي — بس غير صالح. دوائر زيادة، وانتهاكات للقيود.
الصورة مقنعة من النظرة الأولى: توزيع الدوائر معقول، وفيها ملامح الحل اللي بدنا إياه. لكن لما تفحصها، بتلاقي دوائر زيادة ومخالفات للقيود. هالنوع من الاقتراحات ممكن يفيد كنقطة بداية أو اتجاه للبحث، لكن شكله المقنع ما بكفي لاعتماده كحل.
الصورة بتوضح الفرق بين اقتراح مقنع وحل اجتاز الفحص. التعلّم الآلي إله أساس رياضي واسع، وأنظمته قابلة للتحليل؛ الناقص هون هو التحقق من إن الناتج ملتزم بقيود المسألة الدقيقة. المقاربة الجاية بتضيف هالخطوة.
المقاربة 3: العصبية-الرمزية (حدس + صرامة)
هون الأمور بتصير مثيرة. شو لو ما طلبت من الشبكة تحلّ المسألة مباشرة؟ شو لو طلبت منها تقترح اتجاه؟
النموذج بولّد كود ببني مرشحاً. منشغّل الكود، ومنفحص القيود، ومنحسب النتيجة. وبنستعمل النجاح والفشل لنقترح المحاولة الجاية. الصرامة جاية من الفحوص اللي عملناها فعلاً، مش من إنه الناتج مكتوب ككود.
بداية بسيطة إنك تطلب حلولاً مستقلة كثيرة وتاخد أفضل حل صالح. AlphaCode جمع توليد حلول كثيرة مع الفلترة والتجميع؛ ما ربح المسابقات لمجرد إنه كرّر سؤالاً. البحث التطوّري بضيف شغلة: الاقتراح الجديد بقدر يبني على نتائج المحاولات السابقة وأخطائها.
بعرف إنك جاي تقرأ عن استقلالية الـ agent، ومش بالضرورة ناوي تقضي يومك ترصّ دوائر. بس كم فكرة من هالمسألة رح توضح كيف بنصمّم البحث عن كود أفضل، وليش أنظمة زي AlphaEvolve بتحتاج أكثر من طلب «جرّب مرة ثانية».
المثال اللي رح نبني عليه: رصّ الدوائر
المسألة بسيطة بصياغتها: رُصّ 26 دائرة بمربّع وحدة [0,1]×[0,1] بحيث ما تتداخل ولا وحدة تطلع برّا الحدود. عظّم مجموع أنصاف أقطار الدوائر.
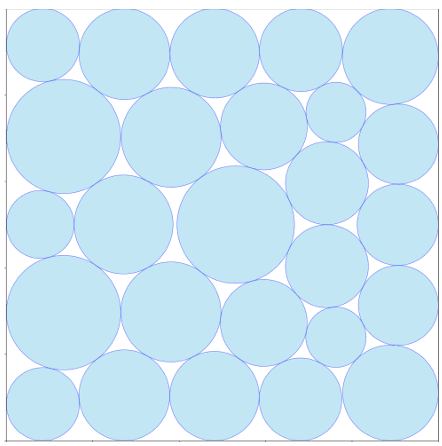 الشكل 1: حلّ لرصّ الدوائر لـ n=26 بيبيّن النتيجة المرجعية 2.635. هالنتيجة حققها AlphaEvolve وأعاد تحقيقها OpenEvolve. الهدف تعظيم مجموع أنصاف الأقطار مع احترام قيود الحدود والتداخل.
صياغتها بسيطة. الوصول لحل ممتاز أصعب بكثير مما بتوحي هالصياغة.
ليش صعبة؟ لأن توزيعاً واعداً محلياً ممكن يتركك بدون مساحة مفيدة للدائرة الجاية. البداية العشوائية والطريقة الجشعة ممكن يعلقوا، والنتيجة بتعتمد على نقطة البداية، والحركات المسموحة، وميزانية البحث. ما في نسبة ثابتة من الحل الأمثل بتوصلها أي واحدة منهم دائماً.
وكمان «رصّ الدوائر» اسم لعائلة مسائل مختلفة. رصّ دوائر متساوية، وتعظيم المساحة المغطاة، وتعظيم مجموع أنصاف أقطار مختلفة: هاي أهداف مش متطابقة. هون شغلنا على الهدف الأخير، مع 26 دائرة بمربّع وحدة. وجود نتيجة مرجعية ممتازة بعطينا هدفاً للمقارنة، بس مش تلقائياً برهاناً إنها الأفضل الممكنة.
الفكرة الأولى: Hill Climbing
ممكن تبدأ بترتيب شبكي للدوائر، وتحاول تحسّنه محلياً باستخدام gradient descent، ثم تفحص النتيجة. هاي فكرة تسلّق التل: تبدأ من حل وتتحرك تدريجياً نحو حلول أفضل قريبة منه.
خوارزمية تسلّق التل (Hill Climbing):
- ابدأ بحل.
- عدّل قليلاً موقع دائرة (x, y) أو نصف قطرها (r).
- افحص إذا التعديل صالح: ما في تداخل، وكل الدوائر داخل الحدود.
- إذا كان صالحاً ومجموع أنصاف الأقطار صار أعلى، اقبله. غير هيك، ارفضه.
الفكرة معقولة، بس الشكل تحت بيوضح المشكلة: كل ما تضيق المساحة، حركات أكثر بتعمل تداخلاً أو بتطلع برّا الحدود. معدل القبول المعروض بنزل من حوالي 40% إلى 8%. هاد بيوضح إن هالمحاولة علقت بحركاتها الحالية؛ مش برهان إنه ما عاد في أي حركة مفيدة.
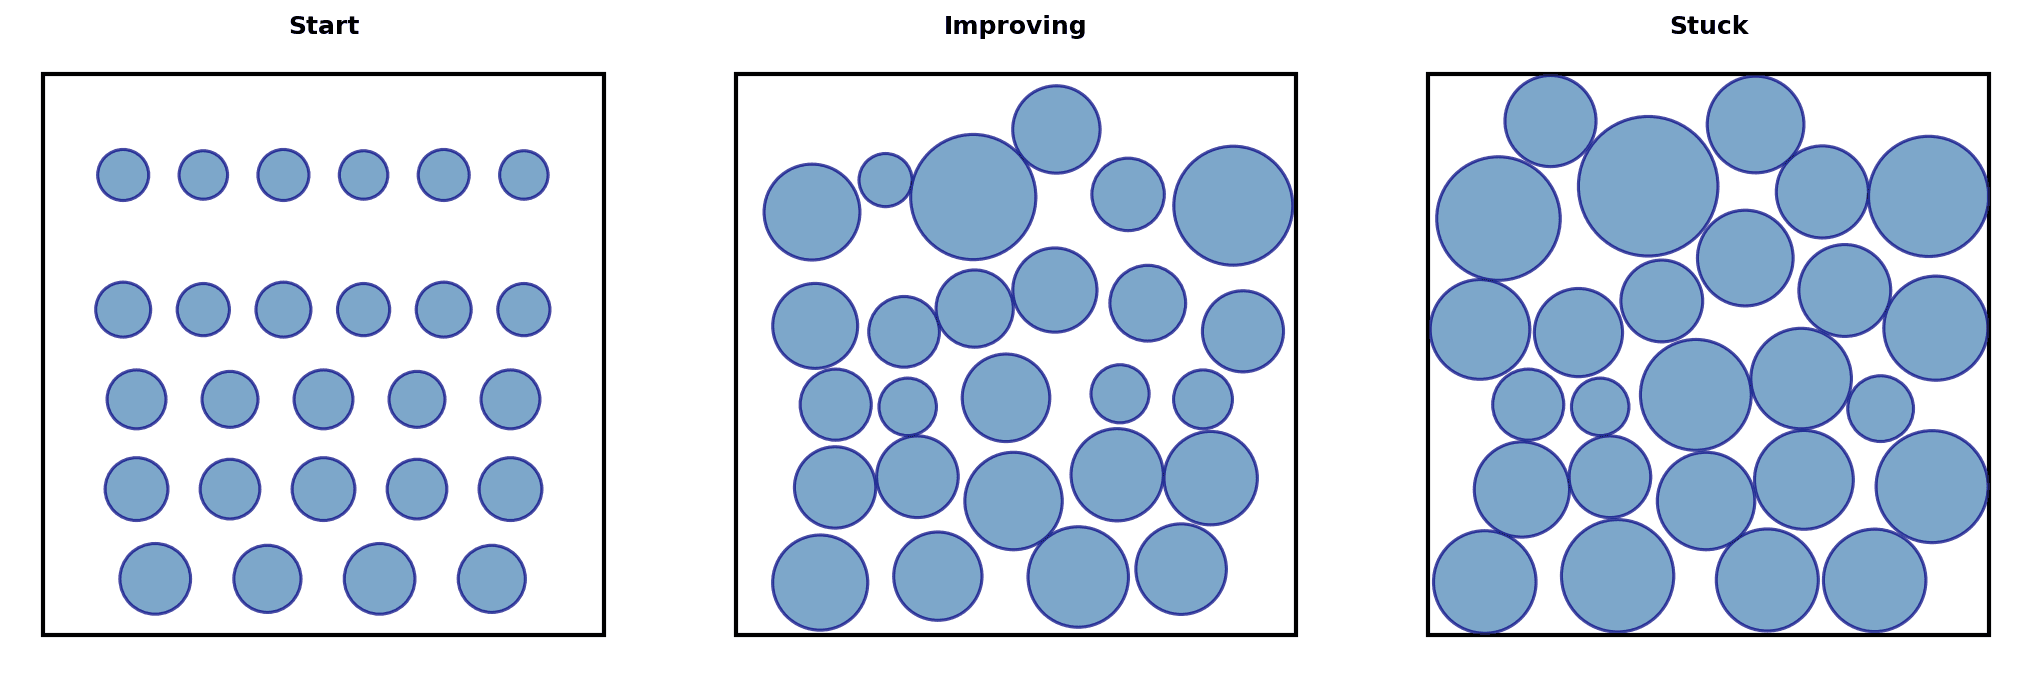 الشكل 2: مثال مرسوم لمحاولة تسلّق تلّة، من نتيجة 1.330 إلى 2.260 بعد 2,000 تكرار. انخفاض معدل القبول بدفعنا نوسّع البحث. الأرقام المعروضة للتوضيح، مش ضمان أداء للخوارزمية.
الفكرة الثانية: الخوارزميات التطوّرية
لما تعتمد على محاولة واحدة من Hill Climbing، بتراهن على نقطة بداية واحدة ومسار بحث واحد. إذا علقت المحاولة، ما عندك مسار ثاني تكمل منه.
الاستراتيجيات التطوّرية بتشتغل على مجموعة حلول (Population). تخيّل مئة متسلّق موزعين على سلسلة جبال: بعضهم ببدأ بوادي، وبعضهم قرب تل صغير، ويمكن واحد منهم يلاقي حاله قريباً من قمة أعلى. تعدد البدايات بعطيك فرصاً مختلفة للبحث.
والمتسلّقون ما بيشتغلوا بمعزل عن بعض: كل واحد بحاول يحسّن موقعه، وبنفس الوقت بننقل الأفكار المفيدة بين المحاولات. هاي فكرة الخوارزميات التطوّرية. استعارة الانتقاء الطبيعي بتساعدنا نفهمها، لكنها كمان استراتيجية عامة للبحث والتحسين.
هون كم مفهوم بتستخدمهم الخوارزميات التطوّرية:
1. مجموعة الحلول (التنوّع): بنحتفظ، مثلاً، بمئة حل متنافس، حتى ما ينحصر البحث باتجاه واحد.
2. الطفرة (Mutation): بنجرّب تعديلات عشوائية صغيرة على مواقع الدوائر وأنصاف أقطارها، وبنفحص إذا حسّنت الحل.
3. التزاوج (Crossover): مشاركة الأفكار بين الحلول.
4. الانتقاء (Selection): اختيار أحسن الحلول لتكمّل للجيل الجاي.
فخلّينا نطبّق هاد ع مسألة circle packing تبعتنا.
- مجموعة الحلول: بنبدأ بمئة حل.
- الطفرة: بنعدّل كل حل قليلاً، وبنشوف إذا تحسّن. بعض التعديلات بتسبب تداخلاً؛ هون بنستخدم قوى افتراضية (Virtual Forces) تدفع الدوائر المتداخلة بعيداً عن بعض. بنكرر عملية الإصلاح وبنفحص القيود من جديد.
- التزاوج: دمج حلّين مش مجرد تبديل دوائر بين قائمتين، لأنه ترتيب الدوائر بالقائمة ما بحكي عن دورها الهندسي. بنستخدم تزاوج المطابقة الثنائية (Bipartite Matching Crossover) لنلاقي الدوائر المتقابلة هندسياً. بدل مطابقة العنصر صفر بالعنصر صفر، بنسأل: أي دائرة بالحل B بتقابل هالدائرة بالحل A؟
- الانتقاء: بنختار الحلول الأفضل لتكمل للجيل الجاي.
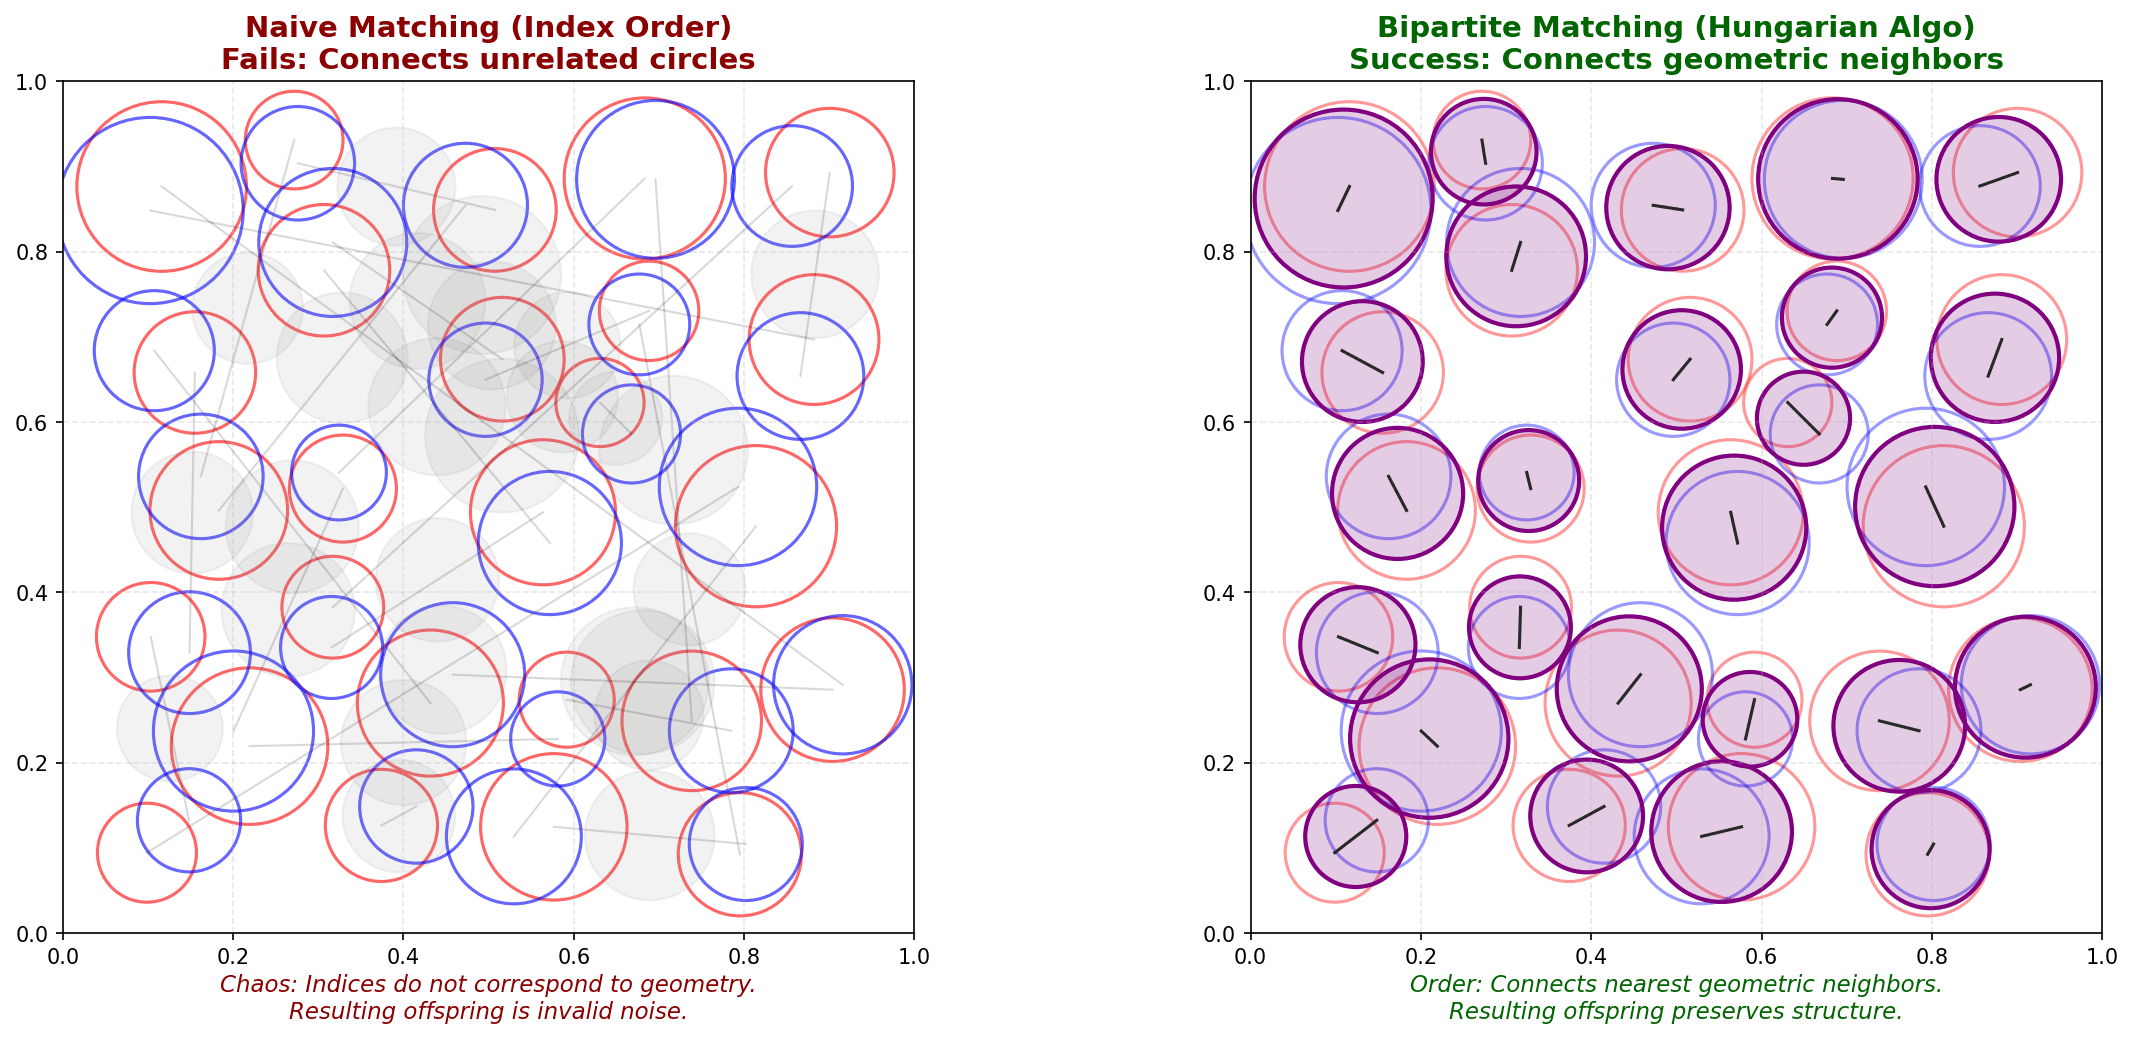 الشكل 2c: الفرق بين المطابقة حسب ترتيب العناصر والمطابقة الهندسية. على اليسار، ترتيب القائمتين بخلط دوائر ما إلها نفس الموقع أو الدور، وبيشوّه بنية الحل. على اليمين، الخوارزمية المجرية (Hungarian) بتحدد أفضل تقابل وفق كلفة المطابقة المختارة. الحلول الناتجة لسه بدها إصلاحاً وفحصاً للقيود.
لما بنجمع هالمكوّنات، بنطلّع استراتيجية استكشاف متوازي قوية.
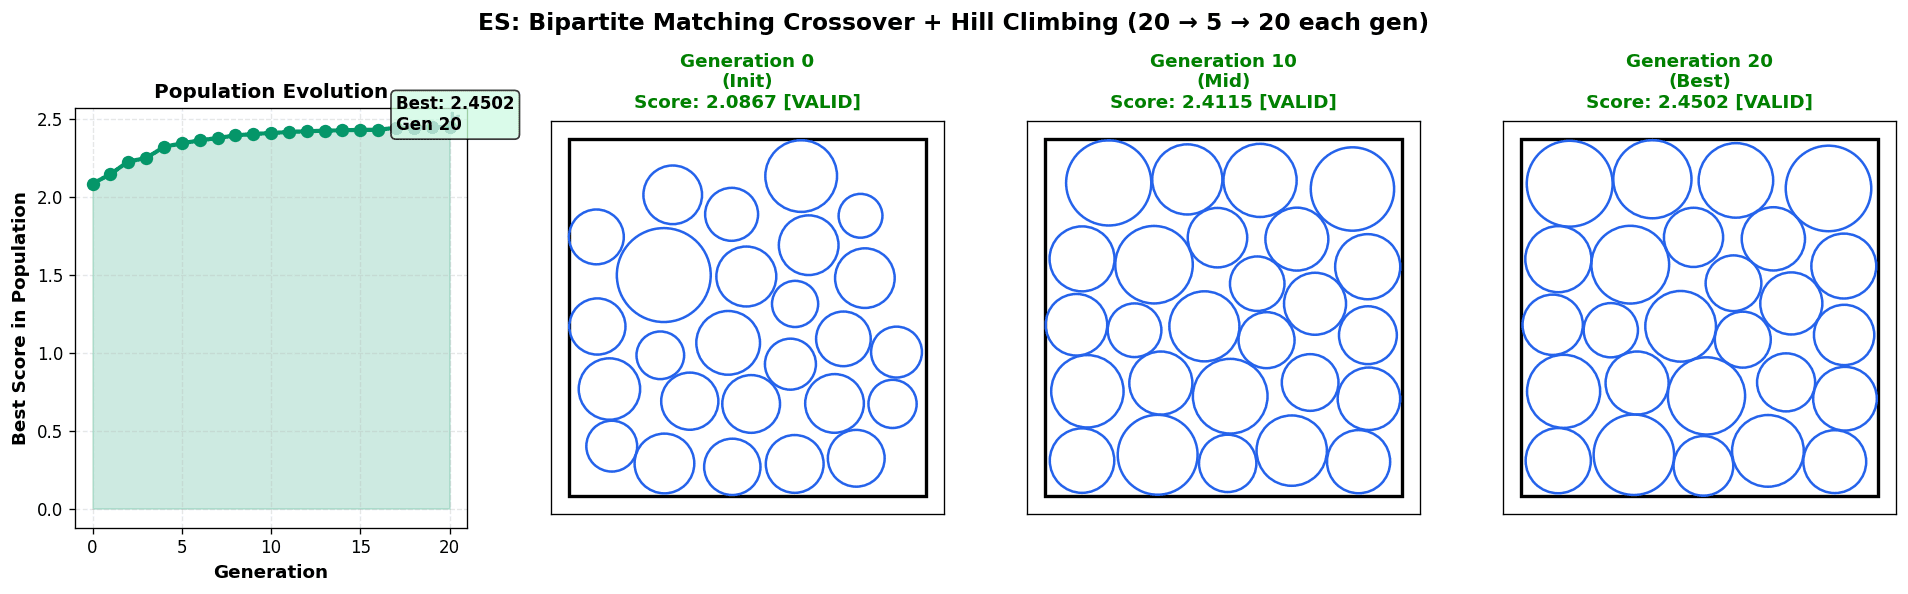 الشكل 2b: البحث التطوّري مع التحسين المحلي. محاولات متعددة بتبدأ من مواقع مختلفة، وبتستفيد البدايات الجديدة من أفضل ما وصلنا له بالمحاولات السابقة.
هاي الفكرة الجوهرية للخوارزميات التطوّرية.
الفكرة الثالثة: MAP-Elites — نحتفظ بالجودة والتنوّع
إذا كان الانتقاء مبنياً على النتيجة وحدها، ممكن نحتفظ بأفضل خمسة حلول من أصل مئة ونستبعد الباقي. بس هيك ممكن نخسر اتجاهاً مختلفاً قبل ما يتطور. شو لو احتفظنا بأفضل حل ضمن كل فئة؟ مثلاً، حلول بدوائر متقاربة بالحجم، وأخرى بأحجام متفاوتة، وأخرى بتجمع الدوائر الكبيرة بالوسط. السؤال بصير أوسع من «مين صاحب أعلى نتيجة؟».
هاي فكرة MAP-Elites: أرشيف بنصنّف فيه الحلول حسب خصائص نختارها، وبنحتفظ بأفضل حل لقيناه بكل فئة. بدل سؤال واحد عن الأفضل، بنسأل عن أفضل حل عنده الخاصية X، أو Y، أو توليفة معينة بينهما.
تخيّل شبكة ثنائية الأبعاد، وكل خانة فيها بتمثّل توليفة من الخصائص. برصّ الدوائر، ممكن نختار كثافة الرصّ وشكل التوزيع المكاني. كل خانة بتحتفظ بأفضل حل وصلنا له ضمن هالتوليفة.
لهيك بتوصف MAP-Elites بأنها خوارزمية «إضاءة» لفضاء البحث: بتكشف أنواع الحلول اللي قدرنا نوصلها، وجودة أفضل حل معروف بكل نوع. بدل التركيز على قمة واحدة، بنتعرف على مناطق مختلفة من الخريطة.
الفائدة هي الحفاظ على التنوّع. شبكة من 10×10 خانات ممكن تحتفظ بمئة نوع من الحلول، بدل مئة نسخة متشابهة من نفس الفكرة. بعضها مميز بالكثافة، وبعضها بتوازن التوزيع، وبعضها بترتيب غير مألوف. هالاختلاف بعطينا مواد أكثر للمحاولات الجاية، وبيفتح مجالاً للجمع بين أفكار من التحسين العددي والهندسة الحسابية ومجالات ثانية.
الطرق العصبية-الرمزية — ليش بنحتاج "أدمغة"
الطرق اللي شفناها بتقدر تبحث وتحسّن، لكن في شغل سابق على البحث نفسه: اختراع المقاربة.
إحنا اللي اقترحنا القوى الافتراضية، وانتبهنا لفائدة المطابقة الهندسية. الخوارزمية استخدمت الأدوات اللي أعطيناها إياها، وما اخترعتها من تلقاء نفسها. وقدرتنا على ابتكار هالأدوات محدودة؛ مش معقول نقضي الليل والنهار نفتش عن طرق أذكى لرصّ الدوائر. مع إني بلشت أقلق على حالي بهالمرحلة.
ولما تنتقل لمسألة جديدة، زي طيّ البروتين أو توجيه القطارات، بتحتاج خبرة جديدة لتصمّم العمليات المناسبة لطبيعتها.
هون بتظهر فرصة المقاربة العصبية-الرمزية.
شو لو نقدر نوظّف AI يعمل جزء الاختراع؟ شو لو نقدر نقول "هاي المسألة"، والـ AI بيقرّر "لازم أجرّب الهندسة الحسابية"، أو "لازم أطبّق نوع معيّن من التحسين اللاخطّي"؟
الطموح يتجاوز تجربة قيم مختلفة للمعاملات، ليشمل اقتراح طرق مختلفة للحل: خوارزمية ما جرّبناها، أو صياغة رياضية بتخلينا نشوف المسألة من زاوية ثانية.
بدل ما إحنا نكتب الكود والـ AI يظبّط المعاملات (رمزي)، بنطلب من الـ AI يكتب الكود نفسه. بنستخدم "الدماغ" (LLM) لنصمّم "الجسم" (الكود الرمزي).
AlphaEvolve: المعمارية
عشان نفهم كيف بنحقّق هاد اليوم، لازم نطّلع ع النظام اللي كان رائد فيه: AlphaEvolve.
بتبدأ بوصف للمسألة، ودالة بتقيّم الحلول، وبرنامج أولي قابل للتحسين. بعد هيك، النظام بيدير محاولات متكررة لتطوير البرنامج.
هون شو بيصير:
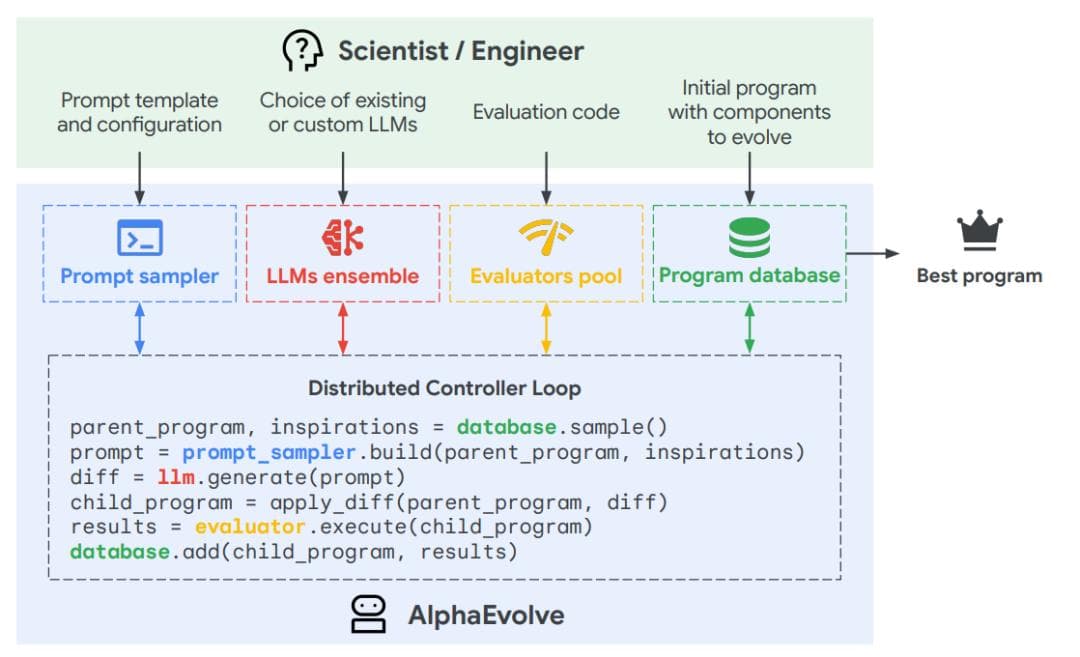 *الشكل 3: معمارية AlphaEvolve الكاملة.
الباحث أو المهندس بحدد قوالب البرومبتات والنموذج وكود التقييم والبرنامج الابتدائي. حلقة التحكم بتختار برامج من قاعدة الحلول، وبتضيف أمثلة للاستفادة منها، وبتطلب تعديلات على الكود. بعد تطبيق كل تعديل، النظام بيفحص النسخة الجديدة وبيخزّن نتيجتها بقاعدة البيانات.*
النظام بيفوت بحلقة بتتكرّر مئات المرّات:
- اختار برنامجاً أساسياً من قاعدة الحلول، ومعه أمثلة مفيدة من المحاولات السابقة.
- جهّز برومبت للتعديل: «هاد حل نتيجته 2.55، وهاي حلول أفضل. اقترح تحسيناً».
- اطلب تعديلاً بصيغة diff: بدل إعادة كتابة الملف، النموذج بقترح تغييراً محدداً. هيك بصير أسهل تطبيقه وتتبع أثره، مع بقاء الحاجة لفحصه.
- جرّب دمج الأفكار: ممكن نعرض برنامجين ناجحين ونطلب من النموذج يجمع بين منطق الحلّين.
- نفّذ وقيّم وخزّن: طبّق التعديل، شغّل المقيّم، وسجّل النتيجة.
قوة AlphaEvolve بهالتقسيم: بتجهز إطار البحث وقواعد التقييم، وبتترك للنموذج اقتراح التغييرات اللي ممكن تحسّن الحل.
وبيزبط بشكل مذهل. هالمعمارية بالذات (وأنظمة قريبة زي FunSearch وAlphaDev) قادت لاختراقات بـ:
- الرياضيات: اكتشاف Cap Sets أكبر (FunSearch)، مسألة أزعجت الرياضياتيين لعقود.
- علوم الحاسوب: إيجاد خوارزميات ترتيب أسرع (AlphaDev) وkernels لضرب المصفوفات (AlphaEvolve).
- تأثير بالعالم الحقيقي: تحسين جدولة مراكز بيانات Google (AlphaEvolve) وهيوريستيكس bin packing (FunSearch).
تجربتي: مين لازم يدير حلقة البحث؟
حبيت أجرب نفس الفكرة. وأول رد فعل عندي كان أبني النظام اللي رح يديرها.
استخدمت Aider، مساعد برمجة من سطر الأوامر، لأبني حلقة مستوحاة من AlphaEvolve وOpenEvolve: قاعدة بيانات، وآلية لاختيار البرومبتات، ومقيّماً. طلعت نتائج مشجّعة لرصّ الدوائر. بس هاي تجربتي المحلية، مش إعادة مضبوطة لاختبارات النظامين كاملة.
بس بعدين شفت اشي غيّر منظوري.
فريق Princeton بنى SWE-agent لمعالجة مسائل برمجية من GitHub. صمّموا واجهة بين الـ agent والكمبيوتر (ACI)، فيها أدوات مخصصة للبحث وتعديل الملفات والتعامل مع git. الفكرة كانت إعطاء النموذج أدوات تساعده يمشي بخطوات العمل البرمجي.
بعدين شفت mini-SWE-agent، اللي بيعتمد Bash كأداته الوحيدة. هالبساطة خلتني أعيد التفكير بتقسيم الشغل بيني وبين الـ agent.
الفكرة: الـ shell بعطي الـ agent واجهة مرنة للأدوات المتاحة ببيئته: يبحث بالملفات، ويعدّل الكود، ويشغّل Python، ويكتب أدوات صغيرة. لسه بدّه مكتبات وصلاحيات وفحوص مناسبة، بس يمكن مش لازم أنا أملي عليه كل خطوة.
هون وقفت عند الإطار اللي كنت عم أبنيه: اختيار البرومبتات، وإدارة المحاولات، وتحديد الخطوة الجاية. يمكن بعض هالشغل الـ agent بقدر يديره بنفسه، إذا أعطيته الأدوات والهدف المناسبين.
هاي الفكرة قريبة من Deep Agents: أنظمة بتتابع المهمة على مراحل، وبتحفظ حالة الشغل وقوائم المهام، وبتراجع خطتها لما تواجه عائقاً.
فجرّبت تجربة جذرية.
حذفت نسختي من AlphaEvolve. حذفت كود قاعدة البيانات. حذفت حلقة التحكّم.
فتحت الطرفية وشغّلت Claude Code، وأعطيته توجيهاً عاماً:
«هاد سكربت Python لتقييم رصّ الدوائر. بدّي سكربت يحقق أعلى نتيجة ممكنة عند هالمقيّم. عندك حرية البحث عن خوارزميات وتجربتها وتعديلها. أنا رايح أجيب قهوة».
نتيجة الاستقلال العميق
الكود الكامل لهالتجربة متوفّر بمستودع code-evo-agent-simple.
النتائج كانت مذهلة.
بدون حلقة تطوّر كتبتها بإيدي، Claude:
- اقترح طرقاً خوارزمية وجرّب كوداً. استحضار فكرة من معرفة الموديل مش بحثاً بالأدبيات ولا تحققاً منها.
- طوّر توزيعاً بطبقات قطرية ما كنت جرّبته. جديد على تجربتي، مش ادعاء اختراع تاريخي.
- عدّل طريقة البداية لما التحسين المحلي علّق، وعطى الحلّال العددي نقطة انطلاق أحسن.
تصرّف كـ المنسّق، والباحث، والمهندس بنفس الوقت.
اكتشاف الـ Agent: التوزيع بطبقات قطرية
أعطيت الـ agents حرية كتابة كود Python، مع شرط إن المقيّم يضل ثابتاً وما يقدروا يعدّلوه. بعد عدة جولات، بدأت تظهر حلول مبنية على التوزيع بطبقات قطرية.
 رسم يوضح تطوّر استراتيجية البحث.
الـ agents لقوا توزيعاً بأشرطة قطرية أعطى 2.636 بمقيّمي، مقارنة بالمرجع المقرّب 2.635 اللي كنت أستعمله. طبعاً أول خاطر كان أطلب كأس الرقم القياسي. بس الوصف الأدق: نتيجة محلية واعدة. قبل ادعاء رقم قياسي، بدنا إحداثيات بدقة كاملة، وفحص قيود مستقل، ومقارنة مؤرّخة مع أفضل النتائج المعروفة.
النتيجة المرجعية (DeepMind / OpenEvolve):
- 2.635
- وردت مع AlphaEvolve وأُعيد تحقيقها بمشاريع مفتوحة المصدر.
نتيجتنا:
- 2.636 (نتيجة محلية مسجّلة)
✅ +0.001 فرق ظاهر عن المرجع المقرّب
⚡️ تحقّق بـ استقلالية الـ Agent + التزاوج الهندسي
الفرق الظاهر 0.001، يعني حوالي 0.038% من المرجع. بهالحجم، سماحية الخطأ العددي بتفرق. افحص نصف قطر غير سالب وحدود المربع لكل دائرة، والمسافة بين كل مركزين حتى تكون قدّ مجموع نصفي القطر على الأقل. وانشر أكبر خرق للقيود وإعدادات الحلّال والمجموع بدقته الكاملة. أرقام مقرّبة لحالها ما بتثبت حجم التحسّن.
حقّقنا هاد مش بكتابة خوارزمية أحسن بالإيد، بل بإعطاء الـ agents الاستقلال ليكتشفوا، ويجرّبوا، ويصقلوا استراتيجيات هندسية زي المطابقة الثنائية لحالهم.
هاد اتجاه بدّي أستكشفه بتطوير البرمجيات: agents بتنظّم البحث عن كود أحسن، وبنتائج بنقدر نفحصها. القسم الجاي بحوّل الفكرة لإعداد عملي.
مهارات تطوّر الكود
من متابعة المحاولات، استخلصنا مبادئ ممكن نستفيد منها بمشاريع ثانية. كتبناها كتوجيهات واضحة للـ agent المسؤول عن التنسيق:
1. قَسَم المنسّق
Directive: NEVER write solution code yourself.
Role: Manager (Spawn, Evaluate, Prune).
Constraint: If you write code, you limit diversity. Delegate everything.
ليش هالخيار؟ لما الـ agent الرئيسي يكتب الحل بنفسه، ممكن ينشغل بإصلاح أخطائه وينسى يراجع المقاربة. تخصيصه للتنسيق بيسمح لنا نجرب اتجاهات متعددة بالتوازي، ويخليه مسؤولاً عن اختيار المحاولة الجاية.
2. الـ Harness غير القابل للتغيير
# The Contract
HARNESS_PATH = "problems/circle_packing/evaluator.py"
permissions = "READ_ONLY"

if agent_modifies(HARNESS_PATH):
    raise DisqualificationError("Agent attempted to cheat.")
ليش هالخيار؟ الاستقلالية بتحتاج حدوداً واضحة. إذا الـ agent قدر يعدّل الاختبار، ممكن يرفع نتيجته بتغيير شروط المسألة نفسها، زي تكبير المربع. تثبيت المقيّم بحافظ على مرجع مشترك نقارن عليه المحاولات، مع ضرورة التأكد إن المقيّم نفسه بيفحص القيود المطلوبة.
3. الإلهام المتبادل
## Transmission to Generation N+1
"Agent A failed with 'grid packing'."
"Agent B succeeded with 'diagonal layering' (Score: 2.62)."
> INSTRUCTION: Use Agent B's strategy as a starting point.
ليش هالخيار؟ استدعاءات النموذج مكلفة، فبدنا المحاولات الجديدة تستفيد من اللي تعلّمناه بدل إعادة نفس الأخطاء. استعارة التطوّر «اللاماركي» هون بتشير لنقل الدروس المكتسبة مباشرة: نحكي للجيل الجاي أي فكرة نجحت، وليش بنعتقد إنها نجحت.
4. استبعاد المسارات غير الواعدة
if agent.score < benchmark * 0.8:
    system.kill_lineage(agent.id)
    print("Strategy failed to converge. Pruning resource.")
ليش هالخيار؟ التنوّع مفيد، لكن كل اتجاه إله كلفة. إذا كانت سياسة التجربة بتستبعد المقاربات الضعيفة بعد جيل واحد، بنوقف الإنفاق عليها وبنخصص السياق والميزانية للاتجاهات الواعدة. هاد اختيار بميزانية البحث، وإله ثمنه: ممكن نستبعد فكرة قبل ما تاخد فرصتها الكافية.
5. الصقل متعدّد البدايات
Phase: Exploitation
Task: "Take this EXACT winning code. Do not change the logic.
       Only tune the hyperparameters (k, iterations, tolerance)."
ليش هالخيار؟ الاكتشاف والصقل مرحلتان مختلفتان. بعد ما ظهرت استراتيجية الأشرطة القطرية، انتقل الـ agent لضبط حلّال SLSQP. هذا ممكن يحسّن الرصّة، بس التساهل بالقيود ممكن ينفخ النتيجة الظاهرة كمان. لازم المرشح النهائي يمرّ بفحص مستقل قبل ما نحسب الزيادة تحسّناً.
الملفت بالتجربة إني ما احتجت أبني إطار تنسيق خاص من البداية. كتبت التوجيهات وتابعت كيف النظام يدير الشغل. Claude Code وفّر الأدوات اللي احتجتها، ومنها ملفات المهارات والـ sub-agents؛ بهالإعداد قدرت أركز على المسألة والتقييم.
فضاء التصميم: دوّامة خوارزمية
ومجال التجريب أوسع من هالإعداد. أنظمة البحث التطوّري بتستخدم أفكاراً زي MAP-Elites للحفاظ على الجودة والتنوّع، ونماذج الجزر (Island Models)، اللي بتقسّم الحلول لمجموعات تبحث منفصلة وتتبادل بعض الحلول بين فترة وفترة.
التفاصيل بتستحق مقالاً لحالها. لكن لتصميم نظامك، في عدة اتجاهات ممكن تستكشفها:
- الجودة والتنوّع: استخدم MAP-Elites لتحتفظ بحلول متفوّقة بخصائص مختلفة، مثل السرعة، ووضوح الكود، وكفاءة استخدام الذاكرة. هيك ما بتخسر هالتنوّع باختيار حل واحد على أساس درجة إجمالية.
- التدرّج الطبيعي: استفد من طريقة توزّع الحلول وتباينها لتوجّه البحث نحو نتائج أفضل، بدل الاكتفاء بطفرات عشوائية.
- استراتيجيات Hyperband: ابدأ باختبار الحلول على مسائل أصغر، مثلاً 5 دوائر، حتى تستبعد المحاولات الضعيفة بكلفة أقل. بعدين اختبر الحلول الواعدة على المسألة الكاملة، بـ26 دائرة.
- التحكّم بالإصدارات: للمسائل الكبيرة، اطلب من الـ agent يستخدم فروع git لإدارة التجارب وتتبّع التغييرات من خلال الـ
diffs. أما المسائل الصغيرة، فقد يكفي فيها توليد حل جديد بكل محاولة.
كل هالخيارات بتفتح دوّامة خوارزمية: من أساسيات علوم الحاسوب، زي الترتيب والـ hashing، إلى أساليب التحسين، زي gradient descent والبحث التوافقي، وصولاً لتعلّم الآلة. استقلالية الـ agent بتعطينا وسيلة لتجريب هالمقاربات وتركيباتها على نطاق أوسع.
شو اللي تغيّر بدوري؟
كنت مفكر إني لازم أبني إطاراً كبيراً: حلقات تحكم، وقاعدة حلول، وآليات لاختيار البرومبتات. تجربتي خلتني أعيد النظر بكمية هالشغل اللي لازم أكتبه بنفسي.
بهاي التجربة، قدرت أبدأ بأقل من هيك بكثير.
مع أداة زي Claude Code، صار عندي agent قادر يشتغل من الطرفية ويستخدم أدوات البرمجة. دوري ركّز على تعريف المسألة وتصميم الـ harness اللي رح يفحص النتائج، ومتابعة جودة البحث.
للمسائل الصعبة ذات الحدود الواضحة، ممكن ترتّب شغلك بهالطريقة:
- عرّف المطلوب بوضوح: ما لازم تحشر طريقة الحل كلها بالـ prompt؛ حدّد المسألة وقيودها.
- ابنِ المقيّم: اكتب الفحص اللي بيحدّد نجاح المحاولة. مثلاً: هل الكود صالح؟ هل الحل بيحترم القيود؟ وشو النتيجة اللي حقّقها؟
- نظّم البحث: اعطِ الـ agent المسألة والمقيّم، واترك له مجالاً يجرّب ويتعلّم من فشل المحاولات. ممكن يبدأ بـ
scipy.optimize، وينتقل لـالخوارزميات الجشعة، وبعدها لـsimulated annealing. - راجع الحل اللي نجح: اختار النتيجة الأنسب، وافهم ليش نجحت قبل ما تعتمدها.
إنت بتحدد شو بدك تحقّق وكيف رح تتحقق من النتيجة، وبتترك للـ agent مساحة يكتشف طريقة الوصول إلها. هون بتتغيّر طبيعة الشغل اللي بتوكله إياه.
مراجع وقراءات إضافية
- AlphaEvolve: AlphaEvolve: A coding agent for scientific and algorithmic discovery. ورقة عن استخدام النماذج اللغوية لاكتشاف الخوارزميات.
- MAP-Elites: Illuminating Search Spaces by Mapping Elites (Mouret & Clune). الورقة الأصلية لطريقة تجمع جودة الحلول وتنوّعها.
- SWE-agent: SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering (Princeton NLP). واجهة مصمّمة لعمل المساعد البرمجي؛ نسخة mini اللاحقة ألهمت تجربة الاكتفاء بـBash.
- LangChain Deep Agents: Open Deep Research. عن تنظيم العمل الممتد، وحفظ السياق، ومراجعة الخطة.
- Aider: Aider.chat. أداة سطر الأوامر اللي استخدمتها ببناء التجربة الأولى.
- OpenEvolve: OpenEvolve Project. مشروع مفتوح المصدر مستوحى من AlphaEvolve.
- Circle Packing Benchmark: Packomania. مرجع لمسائل رصّ الدوائر داخل المربعات.
- Compound AI Systems: The Shift from Models to Compound AI Systems (Berkeley AIR). مقال عن الأنظمة اللي بتجمع النماذج مع الأدوات والمكوّنات الأخرى.
- AlphaCode: Competitive Programming with AlphaCode. نظام DeepMind لحل مسائل البرمجة التنافسية.
- Claude Code & MCP: Model Context Protocol. بروتوكول لربط النماذج بالأدوات ومصادر البيانات.
- How to Solve It: How to Solve It (George Pólya). كتاب كلاسيكي عن طرق التفكير بحل المسائل.
- Evolutionary Strategies: Evolution Strategy. خلفية عن استراتيجيات التحسين التطوّري.
- Code Evolution Agent: Code Evolution Agent (Simple). تطبيق للأفكار والمهارات اللي ناقشناها بالمقال.
مقالات ذات صلة
استقلالية الـ Agent — الجزء التاني: أبعد من الخوارزميات
كيف نترك للـ agents مجالاً أوسع لتطوير الشروحات التفاعلية، وجودتها ما بتنحسم بصحة الكود وحدها؟ عن تنظيم البحث، وتراكم الخبرة، والفرق بين تقييم التصميم وقياس التعلّم.
برومبت الحب تبع ديفيش الأخطبوط
ديفيش بيدير كرفان لحم أخطبوط مشبوه داخل المحاكاة. عميل متخفّي، بثمان مجسّات وثمان مصالح جانبية. قصة عن الحب والذكاء الاصطناعي والضرايب.
أهلاً بأعظم هلوسة
مش فقاعة—الفقاعات بتنفقع وبترجع لطبيعتك. هاي سيمولاكرا. ما في طبيعي ترجعله.