
مقدّمة
بالجزء الأول، استقلالية الـ Agent — كيف تحلّ المسائل الخوارزمية، استخدمت رصّ الدوائر لأستكشف كيف مساعد البرمجة بقدر ينظّم البحث. الخوارزميات التقليدية، والتحسين العددي، والبحث التطوّري، واقتراحات الموديل بتقدر تكمّل بعض. سؤالي العملي كان: قدّيش من التنسيق لازم أكتبه بإيدي؟
الإعداد كان فيه ثلاث شغلات مفيدة:
- هدف محدّد: نتيجة وقيود واضحان.
- مقيّم محمي: الـ agent ما بقدر يعدّل قواعد النتيجة؛ ولسه لازم المقيّم يفحص المسألة الفعلية.
- بيئة برمجة مرنة: الـ agent بقترح كوداً، وبشغّله، وبيراجعه، بدون متحكّم خاص لكل خطوة.
اللي تغيّر بالجزء الأول هو مين بيدير البحث. ما كتبت إطار التنسيق بإيدي، لكن الـ agent كتب وشغّل كوداً فعلياً. نتيجة رصّ الدوائر كانت واعدة، من غير ما تكون رقماً قياسياً متحققاً منه بشكل مستقل. هون بدنا ننتقل لمهمة أصعب من ناحية التقييم.
أبعد من الخوارزميات: شو فعلاً بدّه الـ Vibe Coder يحلّ؟
لما تكون المسألة محددة ونتيجتها قابلة للحساب، بصير أسهل نفحص المحاولات ونقارن بينها. لكن بشغل المنتجات، نادراً ما بتختصر الجودة بدالة تقييم واضحة وثابتة.
خلينا نجرب سؤالاً أقرب لشغل المنتجات: كيف نبني شرحاً تفاعلياً لـMerge Sort وCount-Min Sketch؟ النطاق محدود، بس الجودة بتعتمد على تفاعل إنسان عم يتعلّم. الطموح شرح فيه وضوح مقالات Distill ورسوم Jay Alammar، مش صفحة أزرار بتتحرك والسلام.
خلينا نبدأ بنسخة مرجعية للمقارنة: شروحات بناها مساعد برمجي بطلب مباشر، قبل إضافة حلقة البحث والتحسين اللي رح نحكي عنها:
Merge Sort Visualizer
A Divide and Conquer sorting demonstration.
❓ Recursion
Merge sort uses a top-down recursive approach. It divides the array into single elements before merging them back in order.
❓ Stability
Merge sort is stable, meaning elements with equal values maintain their relative order, which is crucial for multi-key sorting.
❓ Complexity
Time:O(n log n)
Space:O(n)
الشروحات شغّالة، لكنها برأيي ما بتستفيد كثيراً من العرض البصري لتوضيح الفكرة. بتعرض حركة الخوارزمية، وبتترك للمتعلّم شغل فهم معنى هالحركة.
شو معناها إنك تعمل Vibe Code لاشي؟
حتى نفهم وين ممكن تتحسّن النتيجة، خلينا نفصل خمس طبقات بتشتغل عليها لما تبني تطبيقاً بالـ vibe coding:
الطبقة 0: الـ LLM هاي طبقة النموذج نفسه: المعاملات، وTransformer، وattention، والتدريب القبلي واللاحق. المختبرات زي OpenAI وAnthropic وGoogle وMeta بتوفّر نماذج ممكن تبني عليها. بمعظم هالمشاريع، إنت بتستخدم نموذجاً جاهزاً بدل ما تدرّب واحداً من الصفر.
الطبقة 1: agent البرمجة النموذج بقدر يقترح كوداً، لكن مساعد البرمجة بضيف الأدوات اللي بتخلي الاقتراح جزءاً من شغل فعلي: البحث بالمستودع، وتعديل الملفات، وتشغيل الكود واختباره، وإدارة السياق لما تطول المهمة. أدوات زي Claude Code وAntigravity وCursor وAider وDevin بتشتغل بهالطبقة.
الطبقة 2: البنية التحتية للبرمجيات الـ agent صار يكتب كوداً، بس لسه بدك تسجيل دخول شغّال، وقاعدة بيانات، واستضافة، وبيئات اختبار وتشغيل. المنصات بتقدر تجمع بعض هالقرارات بحزمة جاهزة. هاي طبقة البنية التحتية: بتسهّل تشغيل التطبيق، بس ما بتحسم شو اللي بخليه مفيداً.
الطبقة 3: حلّ المسألة نفسها كيف بتحل المسألة الإبداعية نفسها؟ الأدوات بتخطط وبتولّد مرشحين، بس لسه حدا لازم ينتبه إن الديمو الشغّال عم يعلّم الفكرة الغلط. التحدي هون تنظيم هالحكم والبحث اللي بيوجّهه.
الطبقة 4: النيّة والأهداف شو بدك تحقّق فعلياً؟ الهدف نفسه بتوضح ملامحه أثناء الشغل. ممكن تبدأ بطلب «اعرض Merge Sort»، وبعد ما تشوف النسخة الأولى تكتشف إنك بدك «تساعد المتعلّم يفهم ليش بنقسّم المسألة وبعدين بنجمع حلول أجزائها». مراجعة الهدف جزء من التطوير، مش خطوة بنخلص منها قبل ما نبدأ.
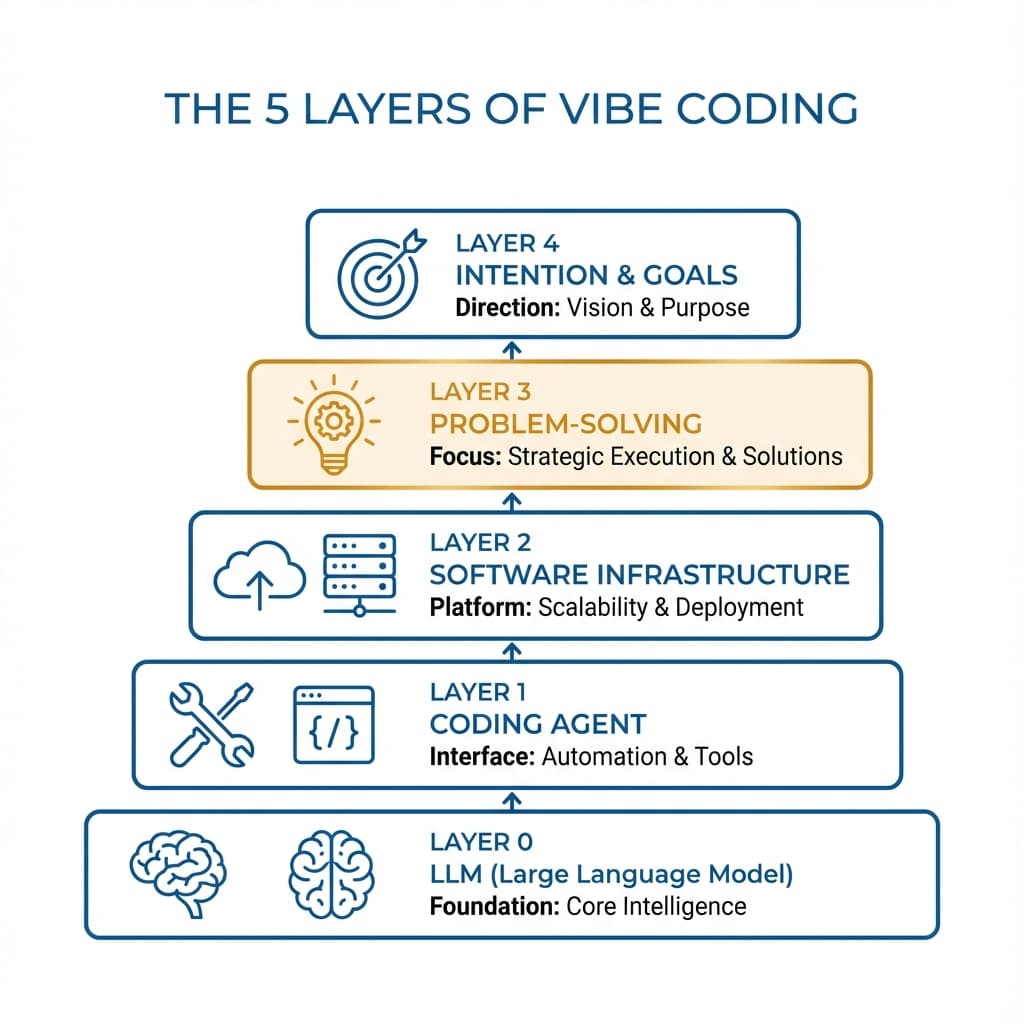
لنفترض إنك بدك شرحاً تفاعلياً لـ Merge Sort. هل المشكلة بتحتاج تدريب نموذج جديد، أم بناء بنية تحتية، أم تحسين طريقة الشرح؟ تحديد الطبقة المناسبة بوفّر عليك شغلاً ما إله علاقة بسبب الضعف. بكتير من هالمهام، التحدي الأساسي بالطبقة الثالثة: كيف نحوّل القدرة والأدوات المتاحة لشرح مفيد؟
الطبقة 3 هي موضوعنا: الحلقة اللي بتحوّل هدفاً مبهماً لمرشحين وأدلة وتعديلات. قديش من هالحلقة بقدر الـ agent يدير بين تدخل بشري والثاني؟
شو بدها مهمة التطوير من صاحبها؟
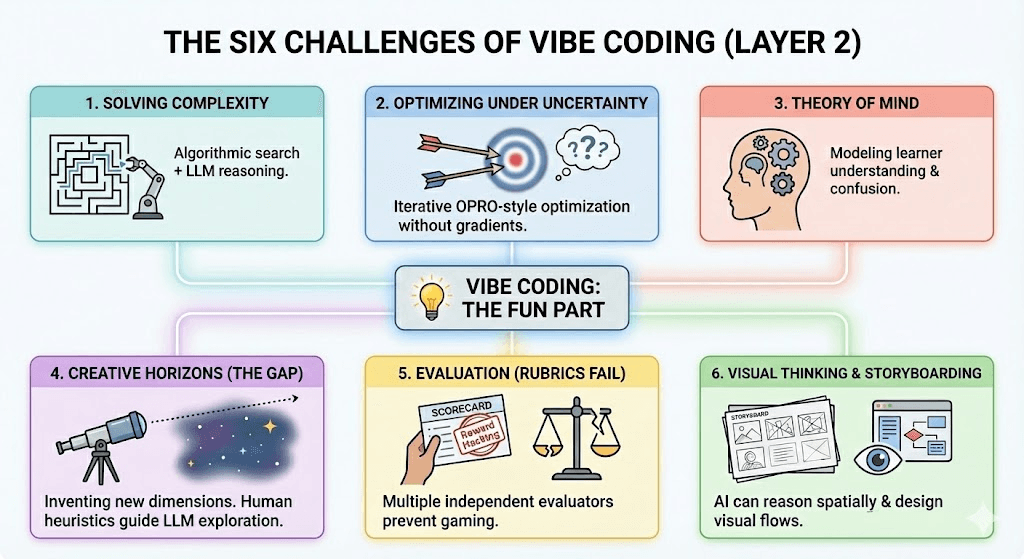
الطبقة 3 هي الجزء الممتع: تبني إشي نجاحه محتاج حكماً، مش مجرد فحص إنه اشتغل. صحة الخوارزمية شرط أساسي. بس بديمو Merge Sort بدنا المتعلّم يفهم ليش بنقسم وبعدين بندمج. بنفحص الكود باختبارات حتمية، وبنفحص التعلّم بأدلة ثانية. ستة تحديات، ومعهم خطوة بحث، بيساعدونا ننظّم الشغل.
رح نمشي بهالتحديات ونرجع بكل واحد لشرح Merge Sort:
1. التعامل مع التعقيد الحسابي
المسألة: بناء شرح تفاعلي بيفتح سلسلة من قرارات التصميم. نعرض الخوارزمية كشجرة أم كصف واحد؟ نستخدم اللون لتمييز الحالة أم العملية؟ نخلي المتعلّم يتحكم بكل خطوة أم نشغّل الحركة باستمرار؟ وكل قرار بيفتح خيارات ثانية، قبل ما نوصل حتى لطريقة تقديم المفهوم.
فضاء التصميم أكبر من إننا نعدّد خياراته بسهولة. هذا ما بخلّي «ابنِ ديمو منيحاً» مسألة NP-hard معرّفة رياضياً. بخلّينا نحتاج استراتيجية بحث: نختار اتجاهات واعدة، نجربها، ونقرر أي عدم يقين بستاهل محاولة ثانية.
بالجزء الأول وسّعنا البحث من الحلول للخوارزميات اللي بتولّدها. بدل ما نصمّم خوارزمية واحدة تبحث عن الحل، أعطينا مساعد البرمجة مجالاً يجرب طرقاً مختلفة للبحث. النموذج بقترح كوداً، والفحوص بتقيّم ناتجه.
بالشرح التفاعلي، بنقدر نعمل حركة مشابهة: نجرب طرقاً مختلفة لبناء الشرح، بدل تحسين تفاصيل أول تصميم خطر ببالنا. نخلي الـ agent يستكشف تمثيلات بصرية، وتسلسلاً مختلفاً للأفكار، وأنماط تفاعل، ونقارن ما بينها.
2. اتخاذ القرار تحت عدم اليقين
المسألة: الشغل الإبداعي برجعلك تقييماً متغيّراً حسب الغرض والمقيّم. منقدر نكتب علامة، بس ما عندنا علامة بتختصر القيمة التعليمية بدقة كاملة. كيف نحسّن الشرح من غير ما نخلط العلامة بالهدف؟
تمهيد سريع عن الـ RL
بالتعلّم الموجَّه، بنعطي النموذج أمثلة مرتبطة بالإجابات المطلوبة. بتعلّم التعزيز (RL)، النظام بياخد أفعالاً، وبراقب نتائجها ومكافآتها، وبيعدّل سلوكه. مثلاً، بدل ما نحدد للروبوت حركة كل مفصل حتى يمشي، بنحدد هدفاً ونكافئ التقدم نحوه، وبنترك له تعلّم طريقة الحركة.
حلقة الـ RL:
- خد فعل بالبيئة
- راقب المكافأة (feedback إيجابي أو سلبي)
- حدّث سياستك لتعظّم المكافآت المستقبلية
- كرّر لتحسّن السياسة؛ السلوك الأمثل مش مضمون
بس هالمقاربة بتخلّف سؤالين:
- كيف نعرّف المكافأة؟ بدنا وصفاً حسابياً للنجاح. كيف نعمل هاد مع طلب زي «خلّي الشرح جذاباً»؟
- قديش بتكلّف التجربة؟ الاستكشاف ممكن يستهلك محاولات كثيرة، خصوصاً إذا كل محاولة فيها تفاعل مع العالم الحقيقي.
ثلاث أفكار قريبة، بس آلياتها مختلفة
نموذج العالم بتوقع جوانب من البيئة حتى الـ agent يقدر يجرّب أفعالاً بالمحاكاة. هذا ممكن يقلّل كلفة التفاعل الحقيقي. بس إذا نموذج العالم غلط، ممكن يطلعلك خطة ممتازة لعالم مش موجود.
Decision Transformer بيمشي بطريق ثاني: بتعلّم من تسلسلات العوائد والحالات والأفعال، وبعدين بولّد أفعالاً مشروطة بالعائد المطلوب. ورقته سنة 2021 اختبرت مهام RL من بيانات مسجلة. طلب عائد أعلى ما بضمن مساراً قابلاً للتحقيق، خصوصاً خارج نطاق البيانات.
النموذج اللغوي المتبع للتعليمات بقدر كمان يقترح خطة من نتيجة مرغوبة: «خلّي الدرس أوضح» ممكن تنتج إظهار الاستدعاء الذاتي، أو إضافة تحكم، أو عرض مثال مضاد. هاي المقارنة اللي بتفيدني. بس التدريب على النص ما بعطيك تلقائياً نموذج عالم موثوقاً، ولا بكشف دالة المكافأة الحقيقية براس المستخدم.
الحلقة العملية: اقترح، راقب، عدّل. النموذج بفسّر «أحسن»؛ والتقييم لازم يفحص إذا تفسيره نفع. ما في اختصار بشيل النصف الثاني من الحلقة.
OPRO: تنظيم التحسين بالبرومبتات
OPRO، أو التحسين باستخدام البرومبتات، بينظّم هالحلقة عند Google DeepMind:
- اعرض على النموذج حلولاً سابقة ونتائج تقييمها.
- اطلب منه اقتراح حل أفضل.
- قيّم الحل الجديد، وضيفه للسجل، وكرر المحاولة.
مثال: بتجارب الانحدار الخطي، OPRO بقترح معاملات جديدة انطلاقاً من مرشحين سابقين وأخطائهم المقاسة. البحث ما بشتق الهدف، بس لسه بحتاج مقيّماً. الورقة بتعرض نتائج لمهام محددة، مش ضمان تقارب لأي مسألة.
بالتحسين على البرومبتات، عرضت الورقة:
- لحد 8% تحسّن ع GSM8K (رياضيات المدرسة)
- لحد 50% تحسّن ع Big-Bench Hard (تفكير معقّد)
- اكتشف prompts زي "خد نفس عميق واشتغل ع هالمسألة خطوة-خطوة"
هالنتائج بتشجّع تجربة بحث موجّه بالنموذج على الكود والتصميم والاستراتيجيات. نجاحه بيظل مرتبطاً بالمهمة والنموذج وطريقة التقييم والميزانية. وصف الهدف بالكلام بيسهّل توجيه البحث، لكنه لحاله ما بضمن التحسّن.
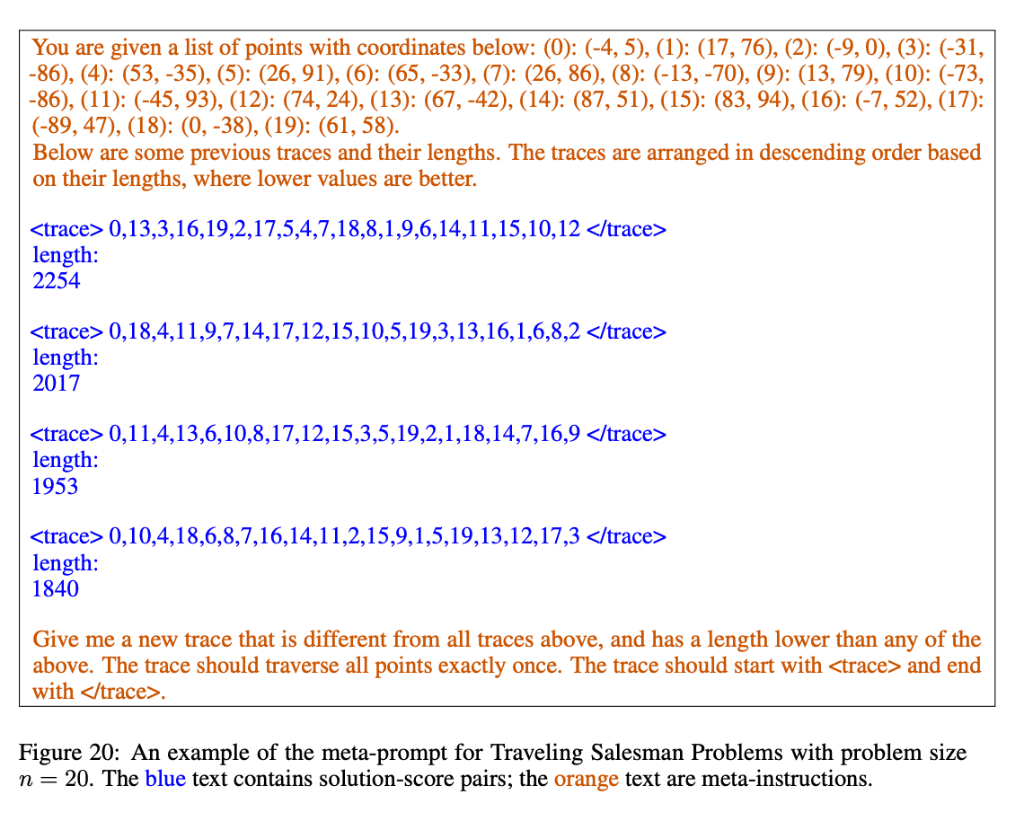
المثال التالي من الورقة عن مسألة البائع المتجوّل. البرومبت بعرض مسارات سابقة وأطوالها، والنموذج بيستخدمها ليقترح مساراً جديداً. بعدها بنحسب طوله حتى نعرف إذا تحسّن فعلاً:
البرمجة كحلقة بحث وتعديل
ممكن نفهم هالجزء من الـ vibe coding كحلقة مشابهة:
- «ابنِ شرحاً تفاعلياً لـ Merge Sort» — نسخة أولى.
- «وضّح الفكرة اللي المفروض الطالب يفهمها» — مراجعة طريقة الشرح.
- «ضيف تحكماً خطوة بخطوة» — تعديل التفاعل.
- «خلّي الألوان تتبع عمق الاستدعاء الذاتي» — تعديل التمثيل البصري.
كل طلب بيوضح جانباً من النتيجة اللي بدنا نوصلها، والنموذج بقترح تعديلات على أساسه.
الفكرة: النموذج بقدر يقترح تعديلات من هدف وأمثلة وتغذية راجعة. هذا بشبه البحث المشروط بهدف، بس ما بعني إن الـ prompting هو نفسه، تقنياً، إجراء التدريب في RL المقلوب.
3. نظرية العقل (Theory of Mind)
المسألة: نجاح التطبيق بيعتمد على الناس اللي رح يستخدموه. بالشرح التعليمي، لازم تتوقع شو المتعلّم رح يفهم، وشو ممكن يسيء فهمه، ووين رح يحتار. هاد قريب من الأسئلة اللي بيدرسها مفهوم نظرية العقل (Theory of Mind): كيف نستدل على معرفة الآخرين ومعتقداتهم ونواياهم؟
بشرح Merge Sort، ممكن الطالب يسأل: ليش كل هالتقسيم قبل الدمج؟ وليش ما نرتب العناصر مباشرة؟ إذا عرضت أعمدة عم تتحرك، ممكن يشوف النتيجة من غير ما ينتبه لبنية الاستدعاء الذاتي. المصمم بدّه يتوقع هالحيرة وهو بيختار طريقة العرض.
وهون الصعوبة: اللي فهم الفكرة وصارت بديهية عنده، ممكن يصعب عليه يتذكر كيف كانت قبل ما يفهمها. التصميم للمبتدئ بدّه تحاول تشوف الشرح بعين شخص ما بعرف اللي إنت بتعرفه.
شو بتقول الأبحاث؟ نماذج لغوية أدّت منيح ببعض اختبارات الاستدلال عن المعتقدات والنوايا والطلبات غير المباشرة. دراسة Strachan وزملائه سنة 2024 لقت كمان اختلافات مهمة بين النماذج والمهام. النجاح بهالاختبارات ما بثبت تجربة ذهنية بشرية، ولا بخلّي النموذج ممثلاً موثوقاً لطالب مبتدئ.
بالديموهات: طلبت من Claude يقيّم شرح Merge Sort كأنه طالب محتار. سأل ليش منضل نقسم قبل ما نورجي فائدة الدمج. هذا اقتراح تصميم مفيد. صار سبب نجرب شرحاً أوضح، مش دليلاً إن الطلاب الحقيقيين عندهم نفس الحيرة بالضرورة.
الفحص الأقوى إنك تطلب من متعلّم يتوقع خطوة الدمج الجاية، ويشرح ليش بتزبط، ويطبق الفكرة على مصفوفة جديدة. ردّ النموذج المتخيّل بساعدنا نصمم الاختبار؛ ما بحل محل نتيجته.
4. توسيع أفق البحث الإبداعي
المسألة: الإبداع مش بس استكشاف فضاء بحث — هو اختراع أبعاد جديدة للاستكشاف.
AlphaGo ما عدّد كل أوضاع Go. جمع إرشاداً متعلّماً مع البحث داخل قواعد ثابتة. بالمهمة الإبداعية ممكن نحتاج نغيّر التمثيل أو السؤال نفسه: طريقة عرض مختلفة بتفتح منطقة مختلفة من التصميم.
مصمم الشرح ممكن يسأل: شو لو عرضنا Merge Sort كشجرة عائلة بدل أعمدة؟ أو تتبعنا قصة عنصر واحد بين التقسيم والدمج؟ هون عم نغيّر طريقة تمثيل المسألة، وبنفتح معها احتمالات جديدة للتصميم.
اللي لسه مش محسوم: إنجاز مهمة أطول وإعادة صياغة مشكلة بإبداع قدرتان مختلفتان. تقرير METR في مارس 2025 قاس أفق مهام برمجية بوقت إنجازها البشري وعتبة نجاح للنموذج 50%. اتجاه التضاعف التاريخي دليل عن ذاك الاختبار، مش قياساً للأصالة ولا وعداً بالمستقبل.
بتجربتنا السؤال أصغر: اقتراح أكثر من تمثيل بصري بعطي شرحاً أحسن من صقل أول فكرة مرة ورا مرة؟ نماذج أقوى ممكن تساعد، وبنقدر كمان نوجّه البحث بأنماط مفيدة من هلأ.
هون بتفيد ملفات المهارات: بنكتب فيها مبادئ وأساليب مجرّبة تساعد بتوجيه البحث، مثل:
- «جرّب تمثيلاً شجرياً بدل الأعمدة».
- «استخدم اللون لتتبّع الحالة مع الوقت».
- «اعرض مقارنة قبل العملية وبعدها».
- «وضّح ليش الخطوة مهمة قبل عرض تفاصيلها».
هالمهارات بتعطي النموذج اتجاهات محددة للاستكشاف. بدل طلب إبداع مفتوح، بنوجّه المحاولة نحو طرق عندنا سبب نعتقد إنها مفيدة، وبعدين بنفحص أثرها.
5. التقييم: شو اللي أثبتناه فعلياً؟
قائمة المعايير ممكن تكشف زرّاً ناقصاً، أو خطأ بالشرح، أو نصاً صعب القراءة. الخلل بيبدأ لما نعتبر اجتياز القائمة دليلاً كافياً على جودة التعلّم. نظام التحسين ممكن يتعلّم كيف يرفع علامته، بينما المطلوب إن الطالب يتعلّم Merge Sort.
مثال CoastRunners بيوضح الفجوة: agent سباق لقى طريقة يجمع نقاط وهو بدور بمنطقة صغيرة بدل ما يكمّل السباق. الدرس عن هدف بديل ما مثّل القصد. مش إنه كل معيار صريح بفشل، ولا إنه حذف قائمة المعايير بخلّصنا من البدائل الناقصة.
1. ابدأ بحالة استخدام. «أي شرح بساعد مبتدئ يتوقع خطوة الدمج الجاية؟» سؤال بعطي التقييم غرضاً واضحاً. والجمهور وهدف التعلّم لازم يكونوا واضحين للباني كمان؛ إذا خبيت عنه معنى النجاح، خربت المهمة.
2. قارن بين نسختين. أحياناً أسهل نختار الشرح الأفضل من إننا نعطي كل واحد علامة من خمسة. بدّل ترتيب العرض عشوائياً، واخفي هوية كل نسخة، واسمح بالتعادل، واطلب تبريراً مرتبطاً بهدف التعلّم. هيك بتنظّم الحكم، لكن ما بتلغي احتمال انحياز المقيّم للتصميم المبهر.
3. استخدم Bradley–Terry لما تناسب افتراضاته المهمة. بنقدر نستنتج ترتيباً مشتركاً من مقارنات زوجية متفرقة إذا كانت شبكة المقارنات متصلة ونموذج التفضيل مناسباً. مش ضروري نقارن كل زوج ممكن. لكن لازم نوضح عدم اليقين والاختلاف بين الأحكام؛ إذا التفضيلات بتشكّل حلقات، اختصار الجودة بمحور واحد ممكن يضلّلنا.
4. استعمل المتصفح كدليل على السلوك. خلّي المقيّم يضغط، ويمشي بالشرح، ويجرّب الحالات الطرفية. هيك بنكشف شغلات قراءة الكود ما بتكشفها: زر شكله شغّال وما بعمل إشي، أو حالة ما بنقدر نوصلها، أو عنوان مخبّى على شاشة ضيقة. بس تعثّر AI بالصفحة ما بثبت تعثّر الطالب، ونجاحه باستخدامها ما بثبت إن الطالب تعلّم.
5. ارجع لمراجع جيدة وللمتعلّمين. الشرح المرجعي بساعدنا نحدد شو اللي أعطاه قيمته: إبراز خاصية بتظل ثابتة أثناء الخوارزمية، أو مثال مضاد مفيد، أو انتقال واضح من الحدس للخطوات. نقارن هالخصائص، بدل مطالبة شرح Merge Sort إنه يشبه فيديو عن تحويل فورييه. وإذا الادعاء عن التعلّم، نختبره بمسألة جديدة بعد استخدام الشرح.
شو بنستفيد من فصل الأدوار؟
افصل الأدوار: الباني يستلم التغذية الراجعة بعد التسليم، والمقيّم يسجّل رأيه قبل ما يشوف آراء غيره. خبّي اختبارات التحقق النهائية والأمثلة الخاصة عن حلقة التحسين. بس الباني لازم يعرف المتطلبات.
هذا بقلّل التسريب والتأثر بأول رأي والتقليد المباشر. ما بخلي المقيّمين مستقلين إحصائياً: نسخ من نفس النموذج ممكن تشترك بنفس الغلطة. وكثرة التغذية الراجعة ممكن تعلّم الباني كيف يستغل مقيّماً مخفياً. المرشح النهائي بده فحوصاً جديدة ومراجعة بشرية.
كل مرحلة بدها دليل يناسبها: اختبارات لفحص صحة الخوارزمية، وتجربة بالمتصفح لفحص السلوك، ومقارنات لاختيار تصميم واعد، واختبارات مع الطلاب لقياس التعلّم. جمعها بسلسلة واضحة أحسن من تحميل علامة واحدة مسؤولية تمثيلها كلها.
6. التفكير البصري وتخطيط الشرح
المسألة: الشرح التفاعلي بده ترتيباً للأفكار داخل مساحة بصرية، وانتقالاً مفهوماً بين المراحل. كيف ممكن نستفيد من قدرات النماذج على الصور أثناء تصميمه؟
اللي شدّني بنماذج توليد الصور هو قدرتها على اقتراح شكل للشرح: شجرة، أو جدول، أو توزيع يربط أجزاء الفكرة ببعض. هالاقتراحات بتعطينا مادة للتصميم، حتى لما تحتاج تصحيحاً بالتفاصيل.
طلبنا من Gemini رسوماً أولية لواجهات شروحات خوارزمية، ببرومبت بسيط: «صمّم شرحاً تفاعلياً لـ[الخوارزمية]». هاي بعض النتائج:
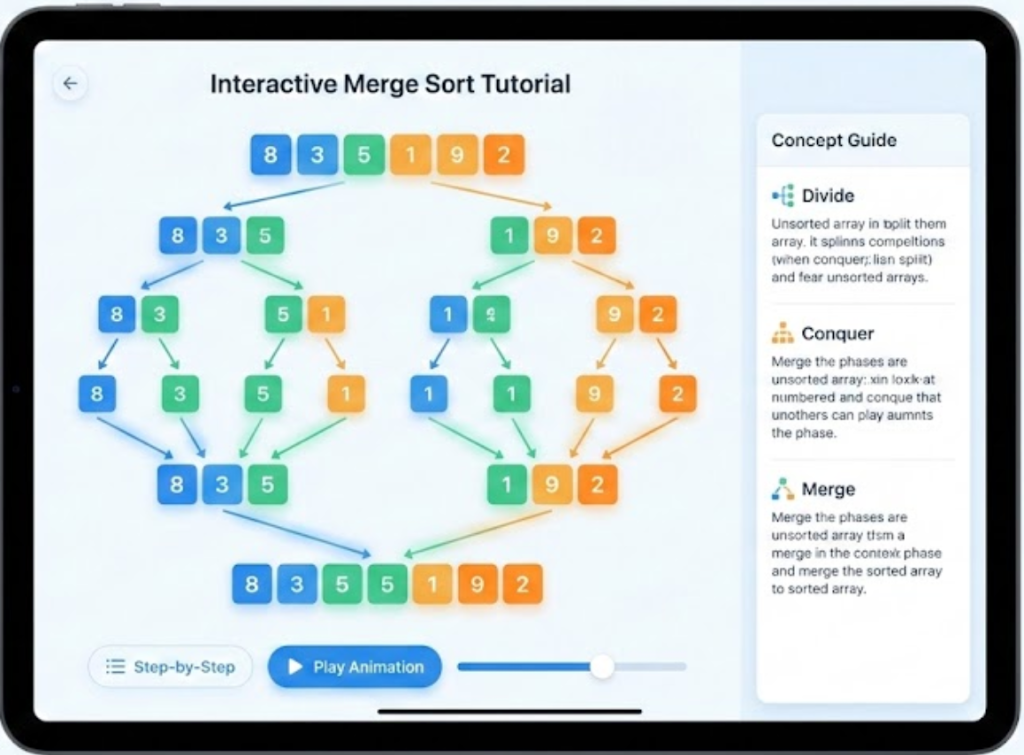
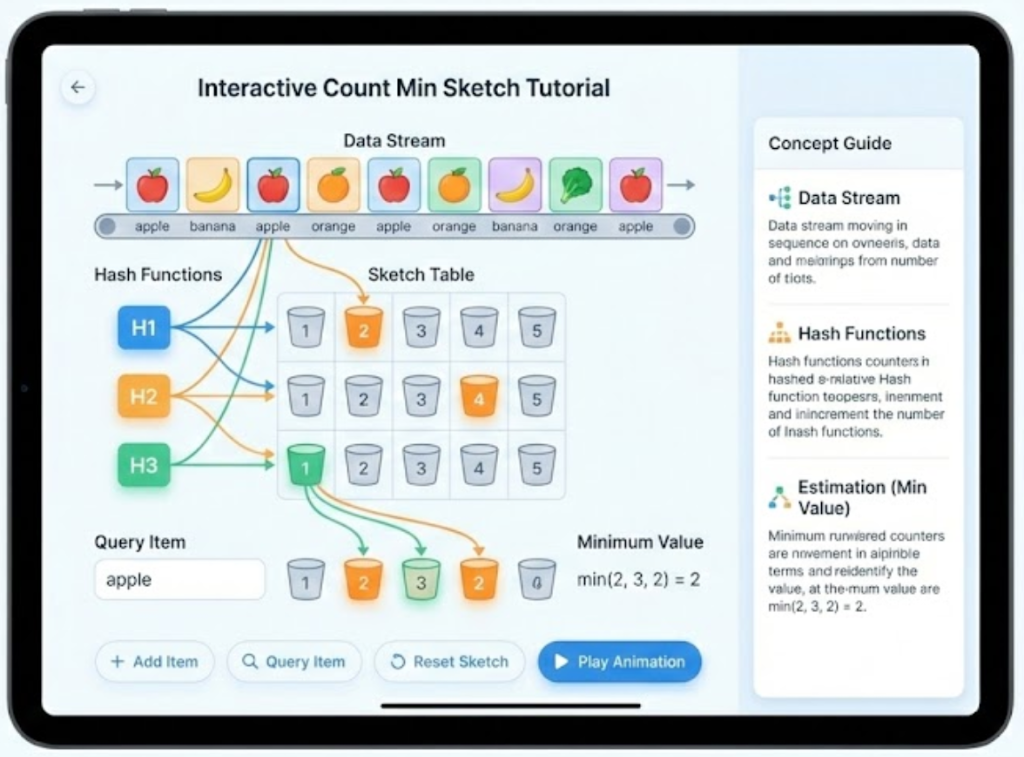
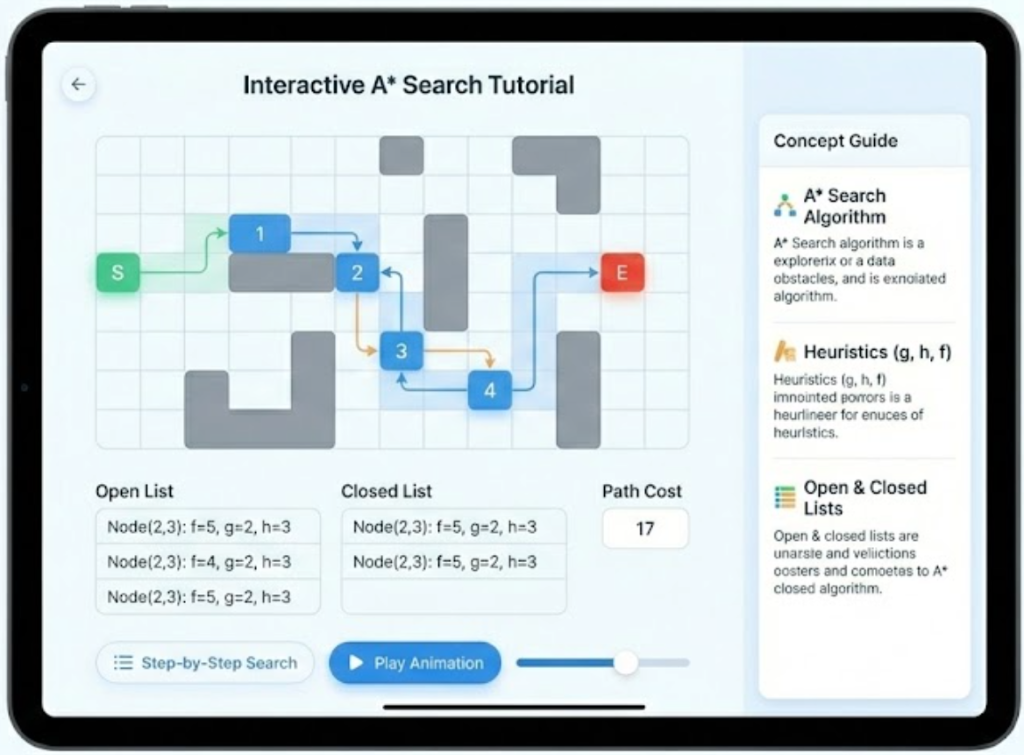
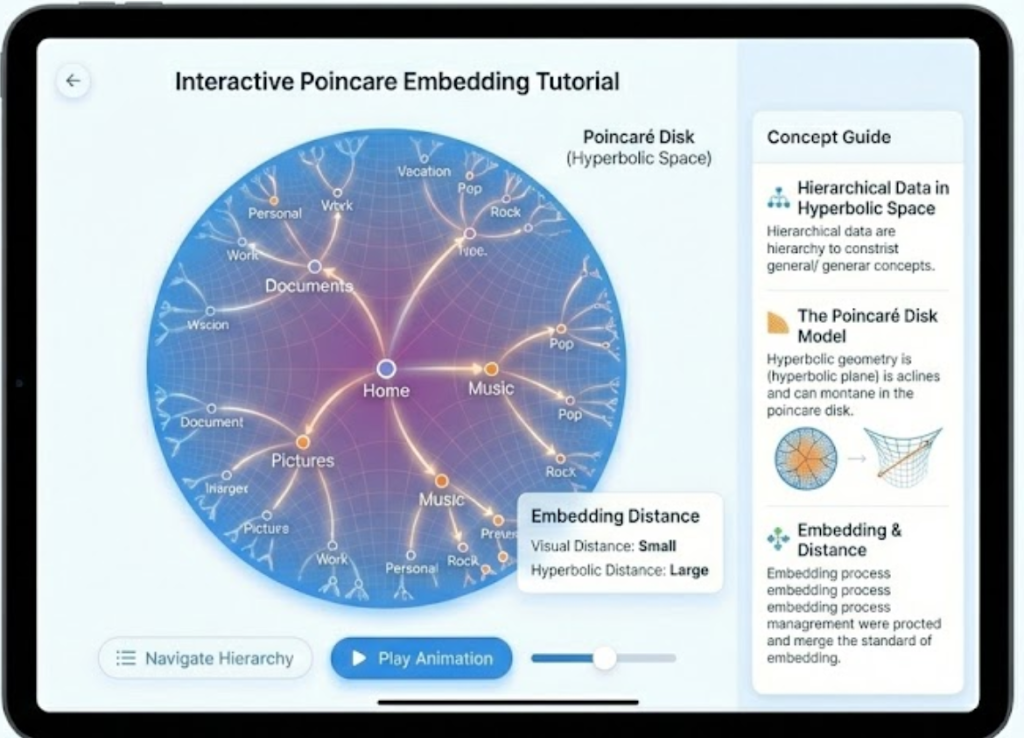
Merge Sort وCount-Min Sketch وA* Search وتضمينات Poincaré بالفضاء الزائدي. الصور بتقترح طرقاً لعرض الاستدعاء المتكرر وتصادمات hash والبحث والهندسة الزائدية. قيمتها التعليمية لسه بدها اختباراً.
هالصور بتعطينا مادة نشتغل عليها بأكثر من مستوى:
- البنية: أشجار الاستدعاء المتكرر، وجداول hash، ورسوم البحث.
- أفكار للشرح: إشارات لونية، وتدرّج بالمفهوم، وتحكّم خطوة بخطوة.
- التصميم: ترتيب بصري وأماكن ممكنة للتفاعل.
بحث Whiteboard-of-Thought من 2024 بعطي مثالاً ملموساً للتنقّل بين النص والصورة: الموديل بكتب كوداً يرسم وسيلة بصرية، وبعدين بفحص الصورة ليكمّل التفكير. الورقة بتعرض نتائج على أربع مهام تفكير بصري ومكاني. هاد بشجّعنا نجرّب الصورة كخطوة وسيطة، بس ما بثبت إن صورة لشرح تعليمي بتعلّم منيح.
بالشروحات التفاعلية: بعض هالصور نصّها مخربط وتفاصيلها غلط. بس يا زلمة، لسه بتعطيني اتجاهاً للتصميم. مساعد البرمجة بقدر يحوّل الاتجاه لتفاعل، وبعدين بنفحص الخوارزمية، وبنجرّب الواجهة، وبنشوف إذا المتعلّم فهم. الصورة فرضية نطوّرها.
7. البحث: نستفيد من اللي سبقنا
المسألة: قديش نخلي الـ agent يبدأ من الصفر، وقديش نوفر له من شغل الآخرين؟ بكل خيار مكاسب وتنازلات.
بداية مفيدة: مساعد عم يبني شرحاً لـ Merge Sort بقدر يراجع شروح Distill و3Blue1Brown وVisuAlgo. أداة البحث بتساعده يجمع مصادر مرشحة، بس لسه لازم يقرأها ويتحقق منها. مسح سريع مش معرفة بحقل كامل.
هون في قرار تصميم: قدّيش من الحل الموجود نوري للباني؟
المثال الكامل بساعد بالتفاصيل والأعراف، بس ممكن يعلّق المساعد بتصميم واحد. المبادئ المستخلصة بتترك مجالاً أوسع للتجريب، بس ممكن تخبّي سياقاً ضرورياً. بختار بينهم حسب الهدف:
- أمثلة وكود لما بدّي إعادة دقيقة أو تعلّم أسلوب معيّن.
- أنماط ومبادئ لما بدّي أستكشف تصاميم بديلة.
- حلول مرجعية محجوبة عن الباني لما بدّي أقيّم شو بقدر ينتج بدون ما يشوف الجواب.
حجب الحل المرجعي بساعد يحافظ على معنى هالتقييم. بس ما بيفرض الإبداع ولا بضمن اختراقاً. الباني لسه بدّه المتطلبات والخلفية الكافية ليشتغل.
بالشروحات التفاعلية: ابدأ بمبادئ زي عرض الحالات الوسيطة وتقليل الحمل الذهني غير الضروري. وإذا المساعد مصرّ يفهم الخوارزمية غلط، أعطه مثالاً محلولاً. تقييد المعلومة أداة لتجربة معيّنة، مش قانوناً عاماً للتصميم الأحسن.
فلسفتنا
المشهد اليوم
الأمثلة بتجمع على تقسيم واضح للشغل: النموذج بقترح، والأدوات بتكشف سلوك الناتج، والمقيّم بقارن، والإنسان بيراجع إذا الأدلة بتجاوب السؤال المقصود. صورة جميلة، وتقييم مرتفع، وطالب فهم الاستدعاء الذاتي، كل واحدة نتيجة مختلفة. المعمارية لازم تساعدنا نربط بينها ونعرف شو أثبتنا بكل مرحلة.
بعض الاختناقات بالمعمارية: تغذية راجعة ضعيفة، شغل مكرر، سياق ناقص، أو بحث ما بجرّب تمثيلاً مختلفاً. وبعضها حدود لقدرة النموذج نفسه. التصميم هون بعالج مشاكل التنظيم؛ ما بثبت إن باقي الحدود اختفت.
Deep Mode: فلسفتنا لاستقلالية الـ Agent
باسم Deep Mode، بقصد نمط عمل بيدير فيه الـ agent جزءاً أوسع من مهمة التطوير: يقترح مقاربات، ويبني نسخاً، ويقارن نتائجها من أكثر من زاوية، ويستخدم دروس المحاولات السابقة. الطلب هون مش مجرد جواب أفضل؛ هو تنظيم بحث يمتد على عدة محاولات.
هاي فلسفتنا بأربعة أجزاء:
1. اشتغل على المستوى المناسب للمشكلة
تقسيم الطبقات بساعدنا نحدد موضع التدخل:
- إذا النموذج ما بقدر يحل المهمة الأساسية، حسّن الطبقة 0 أو 1.
- إذا التطبيق مش شغّال بثبات، صلّح الطبقة 2.
- إذا شغّال وبحسّن الإشي الغلط، افحص الطبقة 3 والهدف بالطبقة 4.
خلط الطبقات ممكن يخلينا نصرف الجهد بالمكان الغلط: نكرر تعديل البرومبت بينما الخلل بمعايير التقييم، أو نصلح البنية التحتية بينما ما حددنا شو اللي بيجعل الشرح مفيداً. الفصل بينها بيوضح السؤال اللي لازم نشتغل عليه.
2. نحفظ الأنماط مع شروطها وتبعاتها
مكتبة الأنماط طريقة نحفظ فيها دروس التجربة بشكل صريح أثناء الشغل: شو النمط، بأي ظروف نفع، وشو المقايضة اللي فرضها. هذا مختلف عن تحديث أوزان النموذج، ومتوافق مع استعمال نماذج متدرّبة بالـ ML أو RL.
النمط بيسجّل أكثر من سلسلة خطوات. لما تختار تمثيلاً شجرياً لخوارزمية فيها استدعاء ذاتي، بتكسب وضوحاً ببنية التقسيم، لكن ممكن تخفي تفاصيل التعامل مع المصفوفة. فهم النمط بيشمل سبب فائدته، والظروف اللي يناسبها، والتفاصيل اللي بيجعلها أقل وضوحاً. وهيك بنقدر نستخدمه بوعي بدل تطبيقه بكل مهمة.
خلينا نفصل شكلين من التكيّف:
- بالتدريب: بنحدّث معاملات النموذج حسب هدف تعلّم.
- بهالحلقة: بنحدّث المنتج، وسجل البحث، ومكتبة أنماط بقدر الإنسان يقرأها.
الحلقة لسه بتستخدم التقييم. كتابة الدرس بالكلام ما بتعني إننا صرنا نتعلّم بلا تغذية راجعة.
ولأن الأنماط مكتوبة، بنقدر نقرأها ونناقشها ونطوّرها مع بعض. بتعطينا لغة مشتركة للتجربة، وممكن نختبر نقلها من الشروحات التعليمية لصفحات التسويق والتوثيق وتعريف المستخدم بالمنتج.
الهدف نحفظ التجربة كدرس قابل للفحص: شو جربنا، شو تغيّر، مين استفاد، ووين النمط فشل. لما تنقل القاعدة لملف مهارة، انقل حدودها معها. وإلا مكتبة الأنماط بتصير راوي واثق زيادة، مش خبرة متراكمة.
3. موسوعة الأنماط
بكتاب A Pattern Language، جمع كريستوفر ألكسندر وزملاؤه 253 نمطاً معمارياً، بينها الاستفادة من الضوء من جهتين بالغرفة. النمط إله اسم، ومشكلة بيعالجها، ومقاربة للحل، وعلاقات بأنماط أخرى. الفكرة إن المعماري يستفيد من خبرة متراكمة وهو بيصمّم مكاناً له ظروفه الخاصة. هالعمل ألهم حركة أنماط التصميم بهندسة البرمجيات، ومنها كتاب Gang of Four. المطلوب فهم العلاقات بين الأنماط واختيار المناسب منها، مش نسخ المبنى كله.
بدنا نفس الشي لاستقلالية الـ agent.
تخيّل موسوعة أنماط للـ Deep Mode:
- تعدد المقيّمين مع فصل أحكامهم: تقليل التسريب والتأثر برأي سابق.
- حجب الحل المرجعي: اختبار قدرة الباني على إنتاج حل قبل رؤية المرجع.
- الربط بين الصورة والكود: استخدام الرسم لاقتراح تصميم، والكود والفحوص لتطويره والتحقق منه.
- الترتيب من مقارنات متفرقة: استخدام Bradley–Terry لاستنتاج ترتيب حين تناسب افتراضاته المهمة.
كل نمط إله اسم، وشروط استخدام، وتبعات موثقة، وعلاقات بأنماط ثانية. هيك بتكبر المكتبة مع التجارب، وبيصير نقل الخبرة بين المجالات قابلاً للفحص.
التوسّع الأفقي هون يعني نختبر الأنماط بمجالات ثانية: التوثيق، وعرض البيانات، وصفحات التسويق، والأدوات الداخلية. بننقل الفكرة، وبنراجع إذا شروط فائدتها لسه متوفرة.
4. المعمارية نفسها
الركيزة الرابعة هي النظام الفعلي: منسّق، بانيين، مقيّمين، متصفّح، مهارات. رح نوريه بالتفصيل تحت. الفكرة الأساسية: فصل المسؤوليات.
- الباني بعرف المتطلبات؛ اختبارات التحقق النهائية بتضل خاصة.
- المقيّمون بسجّلوا أحكامهم منفصلين قبل ما يقارنوها.
- المهارات بتوفّر الخبرة المناسبة أثناء المهمة.
- التفاعل بالمتصفح بوفّر دليلاً على السلوك الفعلي.
حين تصبح الاستقلالية مهارة راسخة
اليوم بنشرح هالأنماط للنماذج ببرومبتات وملفات مهارات، وبنتابع التزامها فيها. أحياناً المنسّق بينسى دوره وببلش يكتب الحل، أو المقيّم بيكشف تفاصيل المرجع للباني. القدرة على تنفيذ التعليمات موجودة، لكن إدارة الشغل باستقلالية ثابتة لسه بتحتاج متابعة.
اللي بتطلع إله هو Fluent Autonomy: تصير إدارة البحث والتقييم وفصل الأدوار مهارة راسخة بالنموذج، ويعرف كيف ينظم المهمة من غير ما نذكّره بكل خطوة. هاد اتجاه بدنا نطوره ونختبره، مش قدرة بنفترض إنها اكتملت.
وحتى بهالحالة، مكتبة الأنماط بتظل مفيدة. الباحث المتمكن بيعرف مجاله، وبنفس الوقت بيرجع للأدبيات. الخبرة المتراكمة ما بتنتهي فائدتها لما تتقن الأساسيات؛ جزء من الإتقان إنك تعرف متى ترجع لها.
هاي الرؤية: agents بتعرف تستفيد من الخبرة البشرية المتراكمة، وتطبّقها وتختبرها، وتضيف إلها دروساً من شغلها.
من الفكرة للتطبيق: نظام لتطوير الشروحات التفاعلية
بنينا نظاماً لتطوير الشروحات التفاعلية على أساس هالمبادئ. خلينا نشوف كيف توزّع الشغل فيه.
المعمارية

المنسّق مسؤول عن إدارة المحاولات، وما بيكتب كود الشرح بنفسه:
- بيكلّف agents بالبناء، مع مهارات واتجاهات محددة.
- بيستلم النسخ الناتجة.
- بيكلّف agents أخرى بتقييمها من خلال المتصفح.
- بيقرر الخطوة الجاية: دمج أفكار، أو تعديل، أو تبسيط، أو محاولة جديدة.
الـ agents المكلّفة بالبناء بتشتغل على اتجاهات مختلفة:
- "الباني A: استخدم تصوير شجري"
- "الباني B: استخدم مسار درس تفاعلي"
- "الباني C: تزاوج — شجرة بالنصّ، دروس ع الجنب"
الـ agents المكلّفة بالتقييم بتفحص الناتج من غير الاطلاع على الكود:
- مقيّم تربوي: بيفتح الـ demo بـ Chrome، بيتفاعل زي طالب
- مقيّم حالات الاختبار: بيشغّل قائمة أهداف التعلّم
كيف بتشتغل الدوّامة الخوارزمية هون؟
المنسّق عنده أكثر من نوع تعديل يختاره. الدوّامة الخوارزمية هون هي مجال البحث بين هالعمليات وتركيباتها:
- crossover — امزج أفكار من كم agent سابق
- add_sophistication — أضف تفاصيل بصرية مفيدة للشرح
- simplify — ركّز على المفهوم الأساسي وخفف التفاصيل المشتتة
- fix_bugs — صلّح المشاكل المكتشفة بالتقييم
- iterate_patterns — جرّب استعارات بصرية جديدة كلياً
- improve_pedagogy — عزّز فعالية التعلّم
المنسّق بيعيّن الاتجاه والعمليات. الـ agents بتكتشف التطبيق.
النسخ الناتجة عن جولات التطوير
النسخ المعروضة تحت اخترناها من جولات التطوير. قارن طريقة الشرح فيها بنسخ البداية. أرقام الأجيال بتحدد النسخ المحفوظة، وما بتمثّل بحد ذاتها قياساً لتحسّن التعلّم.
شو عم تشوف:
Merge Sort: من أعمدة بسيطة إلى شجرة بتعرض المراحل.
- النسخة الأولى: بتشوف العناصر تترتب، بس سبب التقسيم مش واضح.
- النسخة المطوّرة: الشجرة بتوضح بنية الاستدعاء الذاتي، والألوان بتتبع مراحل التقسيم والدمج والترتيب. هدف التصميم إبراز سبب نجاح الدمج؛ فهم الطالب إله بيحتاج اختبار تعلّم.
Count-Min Sketch: من جدول شغّال إلى دروس متدرجة وخريطة حرارية.
- النسخة الأولى: الأعداد بتزيد بالجدول، لكن الشرح المصاحب محدود.
- النسخة المطوّرة: العناصر ملوّنة، وتصادمات hash ظاهرة بالخريطة الحرارية، والدروس بتوجّه الانتباه للمقايضة بين المساحة والدقة.
هالنسخ نتجت عن محاولات متتابعة، كل واحدة بتستفيد من اللي قبلها. تفاصيلها ما إجت من برومبت واحد، وما كتبها إنسان خطوة بخطوة؛ الـ agents اقترحتها ضمن حلقة التنسيق والتقييم.
الخلاصة
الديموهات بتورجي طريقة قابلة للتطبيق لتنظيم التوليد والتعديل. لسه ما بتثبت تحسّن تعلّم الطلاب، ولا حلاً عاماً للحكم على الجودة.
اللي بستحق أعيد استعماله هو المعمارية: مقاربات متعددة، وأهداف واضحة، وفحوص قابلة للتنفيذ، ومقارنات، وسجل بيوضح شو غيّر كل تعديل. النموذج بقدّم اقتراحات؛ والحلقة بتقدّم فرصاً نكتشف وين الاقتراحات بتفشل.
الاختبار المفيد بعد هيك هو مقارنة هالطريقة بمقاربة أبسط بنفس الميزانية، وبمقيّمين وطلاب ما شاركوا بالتطوير. إذا النسخة الجديدة ساعدت الطلاب يشرحوا الفكرة ويطبقوها على مسألة مختلفة، بنقدر نحكم إذا جهد البحث الإضافي استحق كلفته.
هاي الاستقلالية اللي بدي إياها: فترات أطول من الشغل المفيد بين تدخل بشري والثاني، ومعها أدلة كافية نفهم منها النتيجة.
مراجع وقراءات إضافية
OPRO (LLMs as Optimizers): Large Language Models as Optimizers (Yang et al., ICLR 2024). استخدام النماذج اللغوية بالتحسين من غير اشتقاق الهدف.
Theory of Mind in LLMs (Strachan et al.): Testing theory of mind in large language models and humans (Nature Human Behaviour, 2024). مقارنة بين نماذج لغوية وبشر بمهام نظرية العقل.
Theory of Mind in LLMs (Kosinski): Evaluating large language models in theory of mind tasks (PNAS, 2024). دراسة أداء GPT-4 بمهام الاستدلال عن المعتقدات الخاطئة.
Whiteboard-of-Thought Prompting: Whiteboard-of-Thought (2024). استخدام الرسم كخطوة وسيطة بالتفكير.
Reward Hacking: Reward Hacking in RL. عن استغلال أهداف بديلة لا تمثّل القصد.
METR Task Horizons: Measuring AI Ability to Complete Long Tasks (Kwa & West et al., 2025). قياسات تاريخية لأفق المهام البرمجية، منشورة في مارس 2025.
Decision Transformer: Decision Transformer (Chen et al., NeurIPS 2021). صياغة اتخاذ القرار كتعلّم من تسلسلات مسجلة.
AlphaEvolve: AlphaEvolve. مساعد DeepMind للبحث التطوّري بالكود.
Human Compatible: Russell, Stuart. Human Compatible: Artificial Intelligence and the Problem of Control (2019). عن الأهداف وعدم اليقين والتحكم البشري.
A Pattern Language: Alexander, Christopher. A Pattern Language (1977). مرجع فكرة موسوعة الأنماط.
Part 1: Agent Autonomy - Part 1: Algorithmic Problems. المقال الأول اللي بنينا عليه هالنقاش.
مقالات ذات صلة
استقلالية الـ Agent — الجزء الأول: كيف تحلّ المسائل الخوارزمية
بعض المسائل صعبة، لكن نطاقها واضح ونتائجها قابلة للفحص. من رصّ الدوائر إلى البحث عن خوارزميات أفضل: متى تكتفي بتوجيه الـ agent، ومتى تترك له تنظيم المحاولات وتقييمها؟
برومبت الحب تبع ديفيش الأخطبوط
ديفيش بيدير كرفان لحم أخطبوط مشبوه داخل المحاكاة. عميل متخفّي، بثمان مجسّات وثمان مصالح جانبية. قصة عن الحب والذكاء الاصطناعي والضرايب.
أهلاً بأعظم هلوسة
مش فقاعة—الفقاعات بتنفقع وبترجع لطبيعتك. هاي سيمولاكرا. ما في طبيعي ترجعله.